



CMU Q/A Dataset
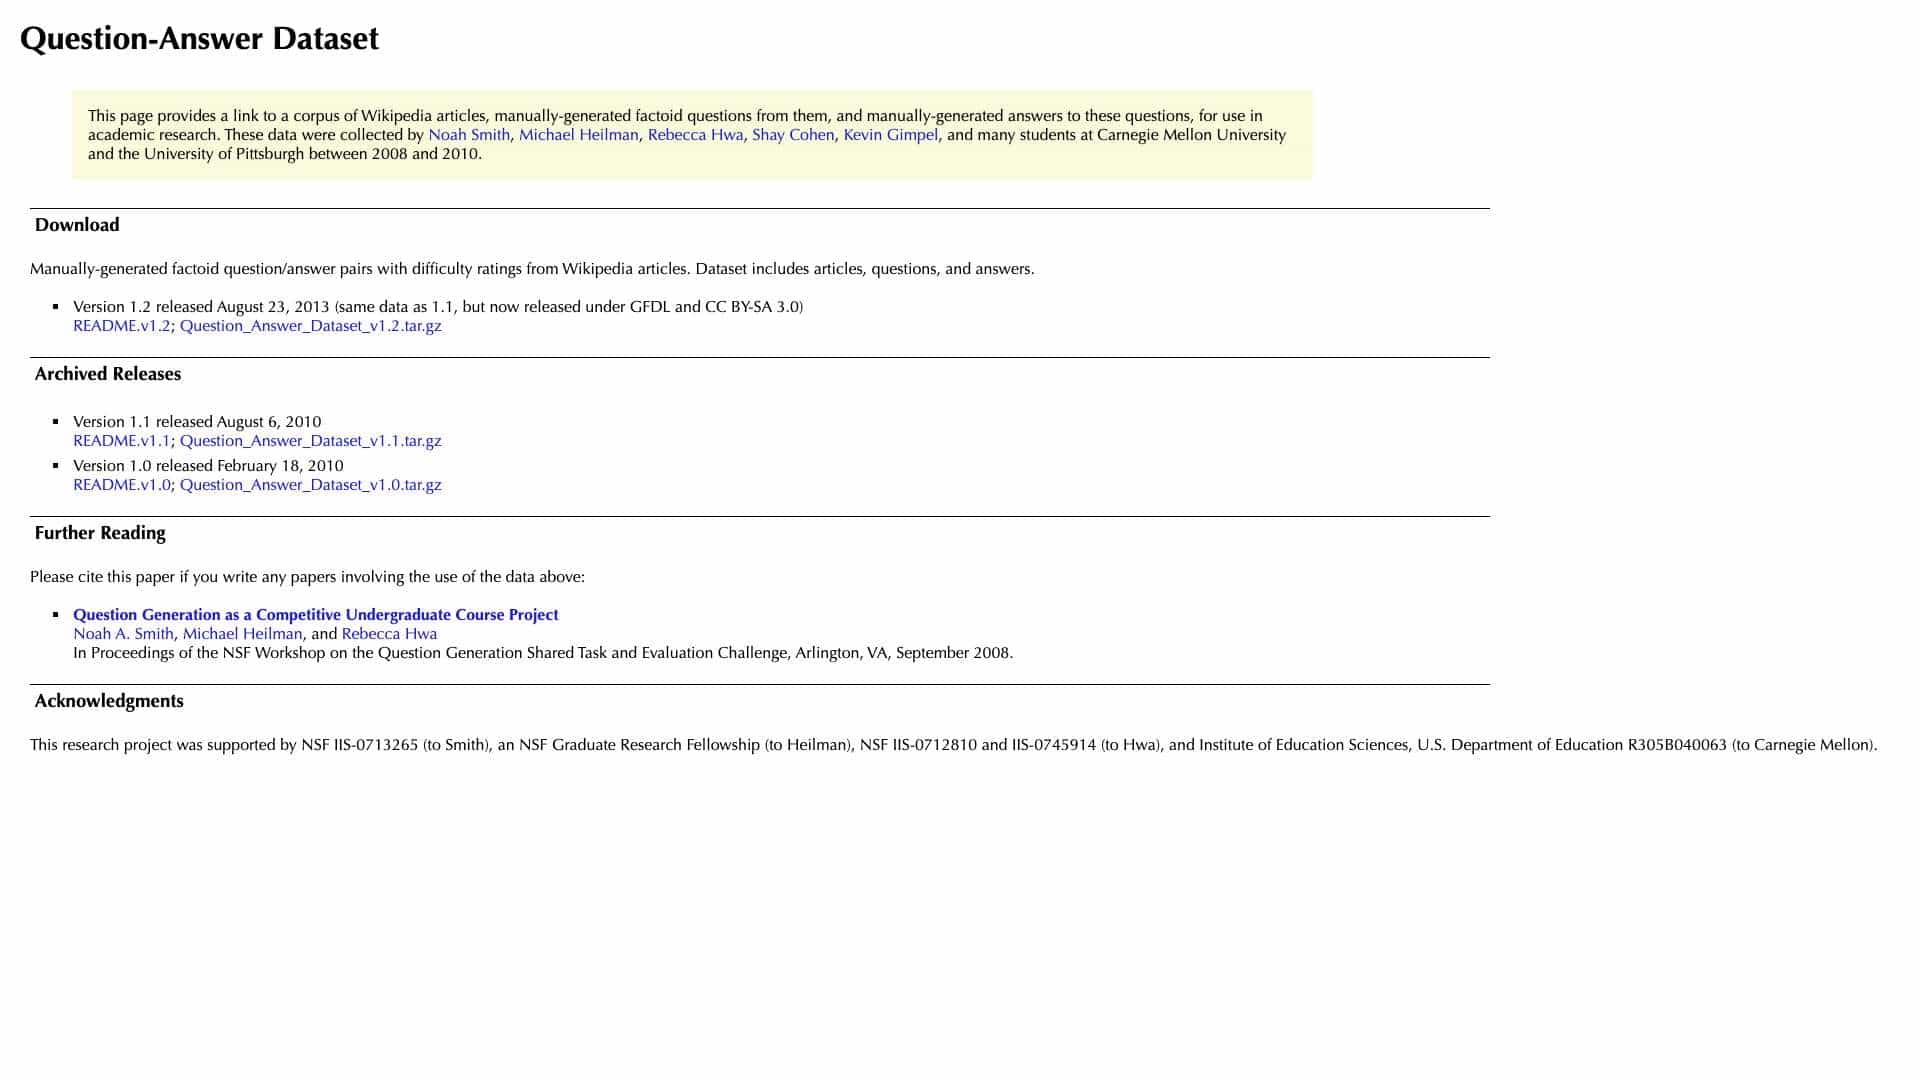
Một tập hợp các bài viết trên Wikipedia với các câu hỏi và câu trả lời thực tế được tạo thủ công cho nghiên cứu học thuật, được thu thập từ năm 2008-2010.
Điểm
30
Đánh Giá Người Dùng
3.0
Hỗ Trợ Miễn Phí/Dùng Thử
Được Hỗ Trợ
Giá Khởi Điểm
--
Cập Nhật Lần Cuối
thg 5 02, 2026
Tổng quan
CMU Q/A Dataset là gì?
Đây là một tập hợp các bài viết trên Wikipedia kết hợp với các câu hỏi và câu trả lời thực tế được tạo thủ công, được thiết kế để sử dụng trong nghiên cứu học thuật về cách tạo và trả lời câu hỏi. Nó bao gồm xếp hạng độ khó và nhiều phiên bản được phát hành theo giấy phép mở.
CMU Q/A Dataset được sử dụng để làm gì?
Tính Năng Hàng Đầu
- bài viết Wikipedia
- Câu hỏi được tạo thủ công
- Câu trả lời được tạo thủ công
- Xếp hạng độ khó
- Nhiều phiên bản có sẵn
- Giấy phép mở (GFDL, CC BY-SA)
Cách sử dụng CMU Q/A Dataset?
Tải xuống các tệp dữ liệu (ví dụ: kho lưu trữ tar.gz) từ các liên kết được cung cấp, trích xuất chúng và sử dụng các bài viết, câu hỏi và câu trả lời cho các dự án nghiên cứu, chẳng hạn như đào tạo hoặc đánh giá các mô hình xử lý ngôn ngữ tự nhiên.
Công Cụ Thay Thế
Không tìm thấy công cụ thay thế
Ưu Điểm & Nhược Điểm
Ưu Điểm
- Chú thích thủ công chất lượng cao
- Hữu ích cho nghiên cứu NLP
- Miễn phí tải xuống và sử dụng
- Bao gồm các trích dẫn học thuật
Nhược Điểm
- Dữ liệu từ năm 2008-2010 có thể đã lỗi thời
- Giới hạn ở các câu hỏi thực tế
- Không có cập nhật hoặc hỗ trợ tích cực
Trường Hợp Sử Dụng
- Nghiên cứu học thuật về trả lời câu hỏi
- Đào tạo mô hình học máy
- Dự án giáo dục trong các khóa học NLP
Giá CMU Q/A Dataset
Gói Miễn Phí
Không có thông tin chi tiết về giá
Đánh Giá Người Dùng
3.0
trên 5
3.0
Chưa có đánh giá
Hãy là người đầu tiên đánh giá công cụ này!