



得分
30
用戶評分
3.0
支援免費/試用
支援
起始價格
--
最近更新
5月 02, 2026
概覽
CMU Q/A Dataset 是什麼?
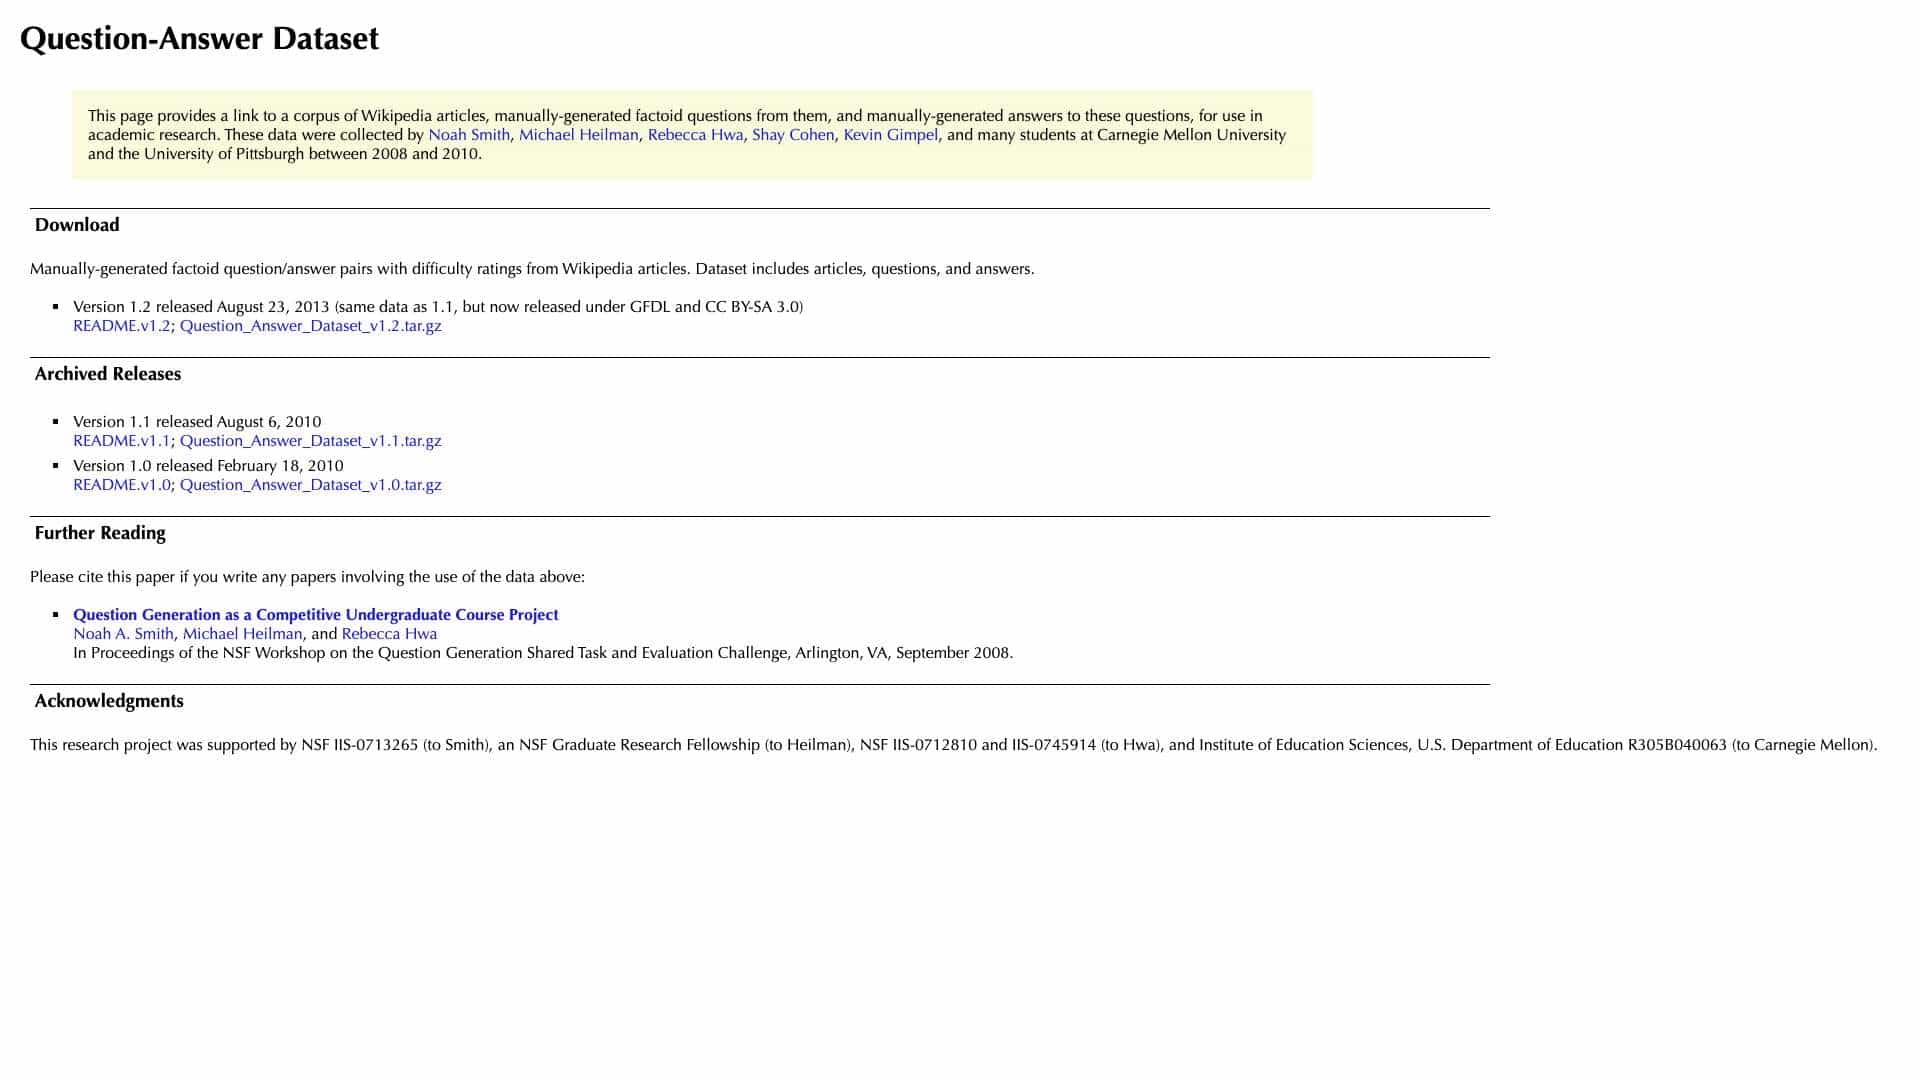
這是維基百科文章的語料庫,配有手動創建的事實問答,旨在用於問題生成和回答的學術研究。它包括難度評級和在開放許可下發布的多個版本。
CMU Q/A Dataset 用於什麼?
主要功能
- 維基百科文章
- 手動產生的問題
- 手動產生的答案
- 難易等級
- 多個版本可供選擇
- 開放授權(GFDL、CC BY-SA)
如何使用 CMU Q/A Dataset?
從提供的連結下載資料集檔案(例如 tar.gz 檔案),提取它們,並將文章、問題和答案用於研究項目,例如訓練或評估自然語言處理模型。
替代工具
未找到替代工具
優點 & 缺點
優點
- 高品質的手動註釋
- 對 NLP 研究有用
- 免費下載使用
- 包括學術引文
缺點
- 2008-2010年的數據可能已過時
- 僅限於事實性問題
- 沒有主動更新或支持
使用場景
- 問與答的學術研究
- 訓練機器學習模型
- NLP 課程中的教育項目
CMU Q/A Dataset 價格
免費方案
暫無詳細定價資訊
用戶評價
3.0
滿分5分
3.0
暫無評價
成為第一個評價此工具的使用者!