



得分
30
用戶評分
3.0
支援免費/試用
不支援
起始價格
--
最近更新
8月 04, 2026
概覽
Billion Words 是什麼?
Billion Words 專案使用 WMT 2011 新聞抓取資料為語言建模提供標準訓練和測試設定。它包括為 Katz 和 Kneser-Ney 等基線模型重建資料和記錄機率值的腳本,從而在 NLP 研究中實現可重複的基準測試。
Billion Words 用於什麼?
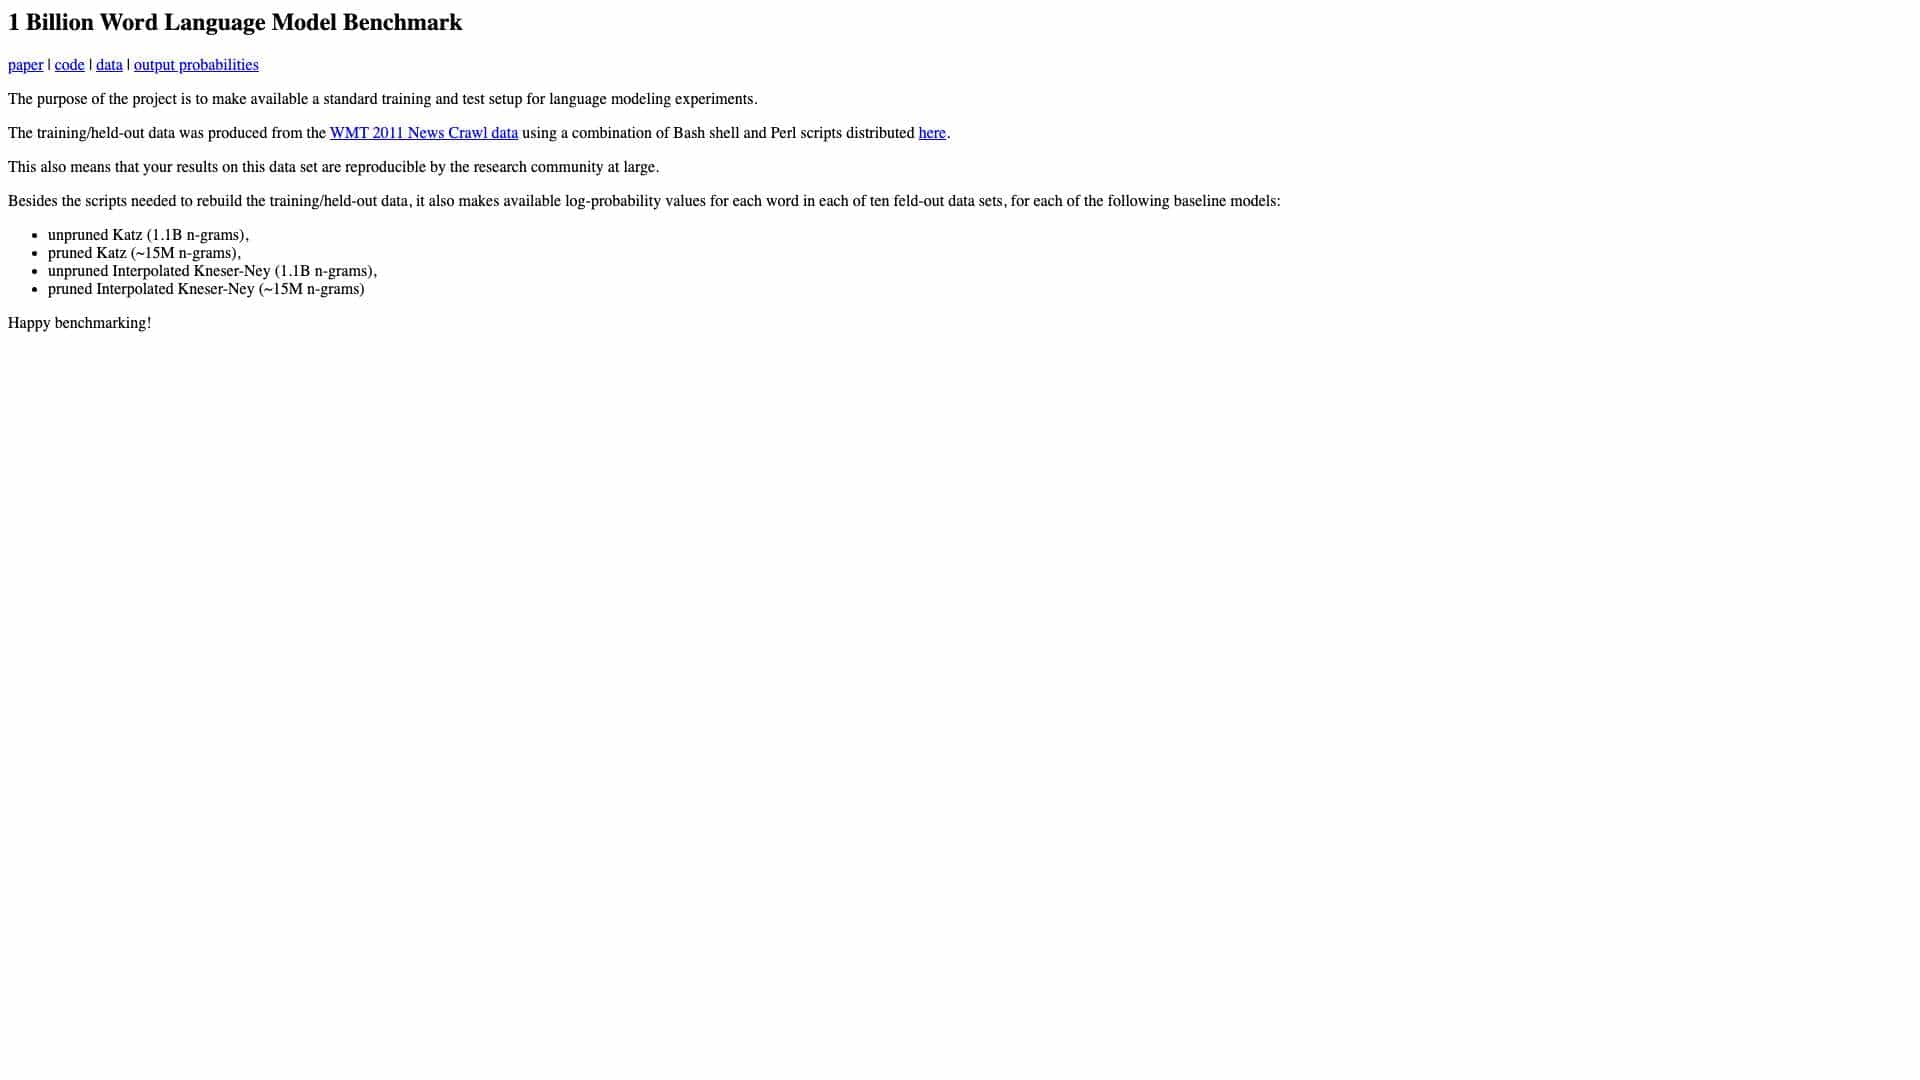
主要功能
- 10 億字資料集
- 訓練和測試數據
- 基準模型輸出
- 可重現的腳本
如何使用 Billion Words?
下載提供的腳本和數據以設定語言建模實驗。使用訓練資料進行模型開發,使用保留的資料進行測試,使用可用的對數機率輸出將結果與基準模型進行比較。
替代工具
未找到替代工具
優點 & 缺點
優點
- 標準化基準
- 可重複的結果
- 免費和開源
- 支援多種型號
缺點
- 需要技術設定
- 僅限於特定資料來源
使用場景
- NLP 研究基準
- 語言模型開發
- 學術實驗
用戶評價
3.0
滿分5分
3.0
暫無評價
成為第一個評價此工具的使用者!