



Billion Words
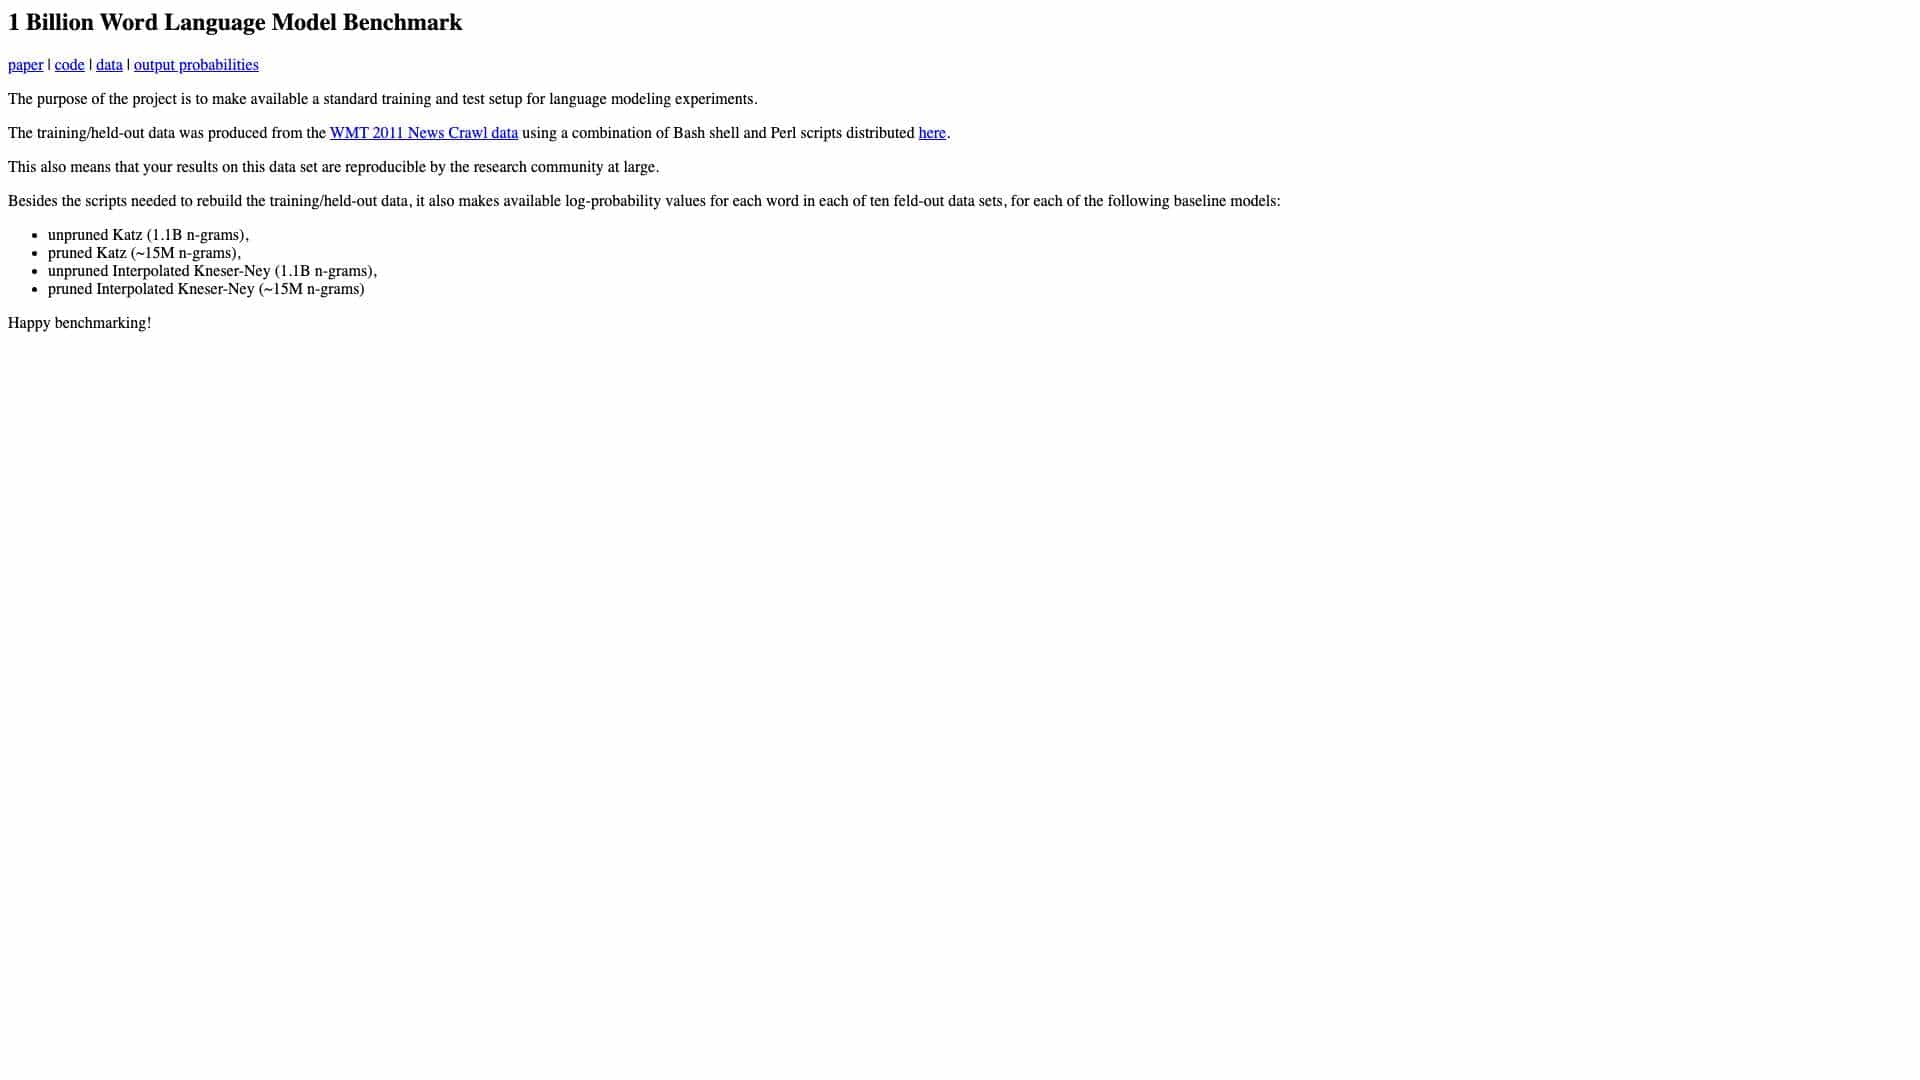
A benchmark dataset for language modeling experiments with 1 billion words, providing training/test data and baseline model outputs for reproducible research.
Puan
30
Kullanıcı Değerlendirmesi
3.0
Ücretsiz/Deneme Desteği
Desteklenmez
Başlangıç Fiyatı
--
Son Güncelleme
Ağu 04, 2026
Genel Bakış
Billion Words nedir?
Milyar Kelime projesi, WMT 2011 Haber Tarama verilerini kullanarak dil modelleme için standart bir eğitim ve test kurulumu sunar. Katz ve Kneser-Ney gibi temel modeller için verileri ve günlük olasılık değerlerini yeniden oluşturmaya yönelik komut dosyaları içerir ve NLP araştırmalarında tekrarlanabilir kıyaslama yapılmasına olanak tanır.
Billion Words ne için kullanılır?
Üst Özellikler
- 1 milyar kelime veri kümesi
- Eğitim ve test verileri
- Temel model çıktıları
- Tekrarlanabilir komut dosyaları
Billion Words nasıl kullanılır?
Dil modelleme denemeleri oluşturmak için sağlanan komut dosyalarını ve verileri indirin. Mevcut log-olasılık çıktılarını kullanarak sonuçları temel modellerle karşılaştırarak, model geliştirme için eğitim verilerini ve test için tutulan verileri kullanın.
Alternatif Araçlar
Alternatif araç bulunamadı
Artılar & Eksiler
Artılar
- Standartlaştırılmış kıyaslama
- Tekrarlanabilir sonuçlar
- Ücretsiz ve açık kaynak
- Birden fazla modeli destekler
Eksiler
- Teknik kurulum gerektirir
- Belirli veri kaynağıyla sınırlı
Kullanım Durumları
- NLP araştırma kıyaslaması
- Dil modeli geliştirme
- Akademik deneyler
Kullanıcı Değerlendirmeleri
3.0
5 üzerinden
3.0
Henüz değerlendirme yok
Bu aracı değerlendiren ilk kişi ol!