



ApacheTajo
Apache Tajo,SQL-on-Hadoop,big data warehouse system on Hadoop,relational and distributed query engine
Puan
30
Kullanıcı Değerlendirmesi
3.0
Ücretsiz/Deneme Desteği
Desteklenmez
Başlangıç Fiyatı
--
Son Güncelleme
Ağu 04, 2026
Genel Bakış
ApacheTajo nedir?
Apache Tajo, Apache Hadoop için tasarlanmış güçlü bir büyük veri ilişkisel ve dağıtılmış veri ambarı sistemidir. Gelişmiş sorgu optimizasyonu ve hata toleransı ile SQL standartlarını destekler, düşük gecikme süreli geçici sorgulara, çevrimiçi toplamaya ve HDFS ve diğer kaynaklarda depolanan büyük veri kümeleri üzerinde ETL'ye olanak tanır.
ApacheTajo ne için kullanılır?
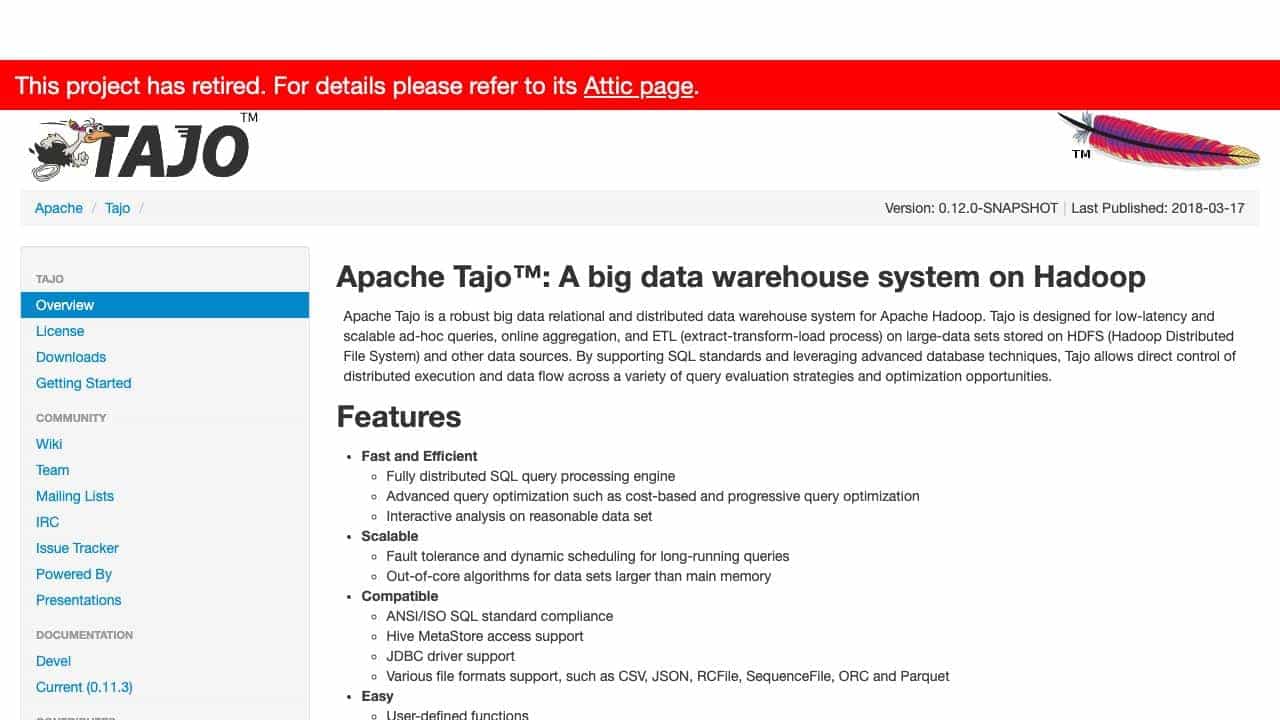
Üst Özellikler
- Dağıtılmış SQL sorgu işleme
- Gelişmiş sorgu optimizasyonu
- Hata toleransı ve dinamik planlama
- ANSI/ISO SQL uyumluluğu
- Çeşitli dosya formatları desteği
- Kullanıcı tanımlı işlevler
- Etkileşimli kabuk
- JDBC sürücü desteği
ApacheTajo nasıl kullanılır?
Tajo'yu Hadoop kümelerine dağıtın, verileri sorgulamak için SQL kullanın, bağlantı için JDBC'den yararlanın ve büyük veri kümelerinde veri işleme ve analiz için etkileşimli kabuğundan ve API'lerinden yararlanın.
Alternatif Araçlar
Alternatif araç bulunamadı
Artılar & Eksiler
Artılar
- Büyük veri için ölçeklenebilir
- Düşük gecikmeli sorgular
- Açık kaynak ve ücretsiz
- Hadoop ekosistemiyle uyumlu
- Birden fazla veri kaynağını destekler
Eksiler
- Kullanımdan kaldırılan proje (aktif geliştirme yok)
- Hadoop altyapısı gerektirir
- Yeni başlayanlar için dik öğrenme eğrisi
Kullanım Durumları
- Büyük veri analitiği ve raporlaması
- Hadoop'ta ETL süreçleri
- Etkileşimli veri keşfi
- İşletmeler için veri depolama
Kullanıcı Değerlendirmeleri
3.0
5 üzerinden
3.0
Henüz değerlendirme yok
Bu aracı değerlendiren ilk kişi ol!