



SQuAD
Stanford Question Answering Dataset (SQuAD) is a new reading comprehension dataset, consisting of questions posed by crowdworkers on a set of Wikipedia articles, where the answer to every question is a segment of text, or span, from the corresponding reading passage. With 100,000+ question-answer pairs on 500+ articles, SQuAD is significantly larger than previous reading comprehension datasets.
คะแนน
30
คะแนนผู้ใช้
3.0
การสนับสนุนฟรี/ทดลองใช้
รองรับ
ราคาเริ่มต้น
--
อัปเดตล่าสุด
พ.ค. 02, 2026
ภาพรวม
SQuAD คืออะไร?
ชุดข้อมูลการตอบคำถามของ Stanford (SQuAD) เป็นชุดข้อมูลเพื่อความเข้าใจในการอ่านที่ประกอบด้วยคำถามในบทความ Wikipedia โดยที่คำตอบคือช่วงข้อความจากข้อความต่างๆ SQuAD2.0 เพิ่มคำถามที่ไม่มีคำตอบเพื่อทดสอบความสามารถของระบบในการงดเว้นเมื่อไม่มีคำตอบ
SQuAD ใช้สำหรับอะไร?
คุณสมบัติหลัก
- ชุดข้อมูลการอ่านเพื่อความเข้าใจ
- รวมคำถามที่ตอบได้และตอบไม่ได้
- มีสคริปต์การประเมินผล
- ลีดเดอร์บอร์ดสำหรับการเปรียบเทียบรุ่น
- ดาวน์โหลดฟรีภายใต้ใบอนุญาต CC BY-SA 4.0
วิธีใช้ SQuAD?
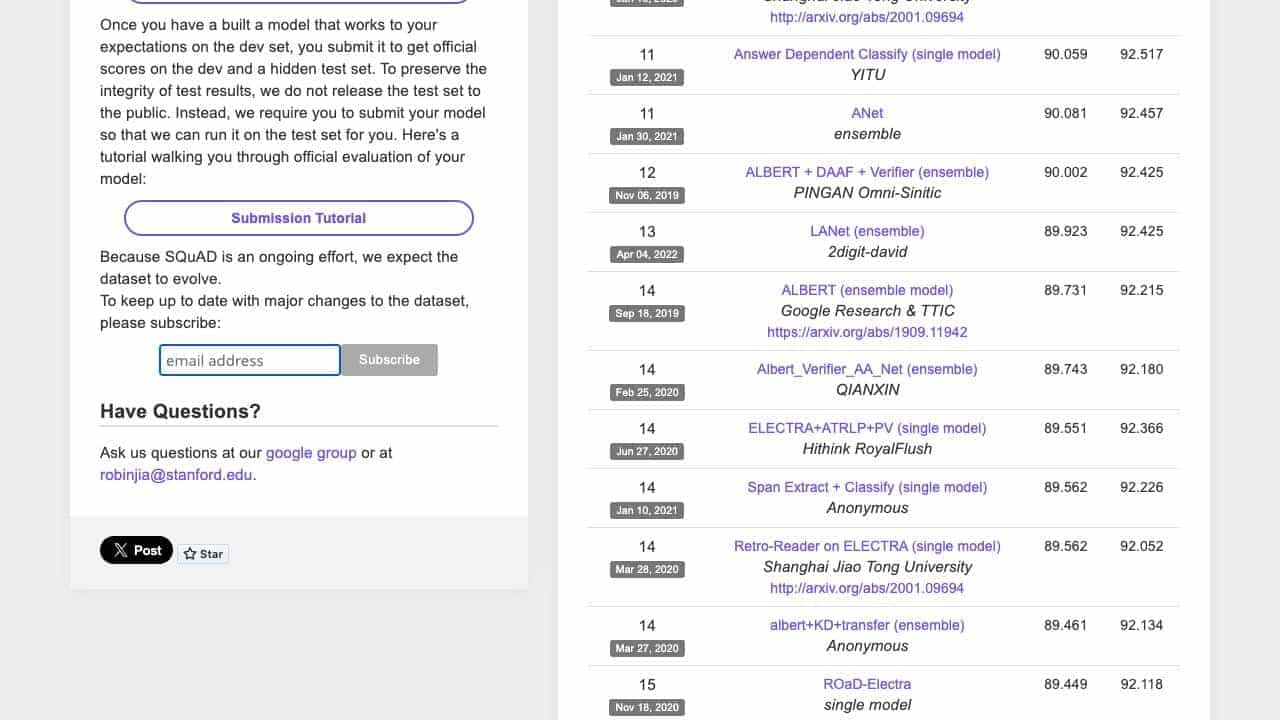
ดาวน์โหลดชุดข้อมูล ใช้สคริปต์การประเมินผลเพื่อทดสอบโมเดลในชุด dev และส่งแบบจำลองสำหรับการให้คะแนนอย่างเป็นทางการสำหรับชุดการทดสอบที่ซ่อนอยู่ผ่านบทช่วยสอนที่ให้ไว้
เครื่องมือทางเลือก
ไม่พบเครื่องมือทางเลือก
ข้อดี & ข้อเสีย
ข้อดี
- มาตรฐานคุณภาพสูงสำหรับ NLP
- ฟรีและโอเพ่นซอร์ส
- รองรับการประเมินและการส่งแบบจำลอง
- ใช้กันอย่างแพร่หลายในการวิจัยทางวิชาการ
ข้อเสีย
- จำกัดเฉพาะข้อความภาษาอังกฤษ
- ต้องใช้ความเชี่ยวชาญด้านเทคนิคในการใช้งาน
- ไม่มีเครื่องมือในตัวสำหรับการฝึกโมเดล
กรณีการใช้งาน
- ฝึกอบรมโมเดล AI สำหรับการตอบคำถาม
- การวิจัยทางวิชาการด้าน NLP
- การเปรียบเทียบระบบการเรียนรู้ของเครื่อง
ราคา SQuAD
แผนฟรี
ไม่มีข้อมูลราคาโดยละเอียด
รีวิวผู้ใช้
3.0
จาก 5
3.0
ยังไม่มีรีวิว
เป็นคนแรกที่รีวิวเครื่องมือนี้!