



SQuAD
Stanford Question Answering Dataset (SQuAD) is a new reading comprehension dataset, consisting of questions posed by crowdworkers on a set of Wikipedia articles, where the answer to every question is a segment of text, or span, from the corresponding reading passage. With 100,000+ question-answer pairs on 500+ articles, SQuAD is significantly larger than previous reading comprehension datasets.
Балл
30
Пользовательский рейтинг
3.0
Бесплатная/Пробная поддержка
Поддерживается
Начальная цена
--
Последнее обновление
мая 02, 2026
Обзор
Что такое SQuAD?
Стэнфордский набор данных ответов на вопросы (SQuAD) — это набор данных о понимании прочитанного, состоящий из вопросов по статьям Википедии, где ответы представляют собой фрагменты текста из отрывков. SQuAD2.0 добавляет вопросы, на которые нет ответа, чтобы тестовые системы могли воздерживаться, когда ответа нет.
Для чего используется SQuAD?
Основные функции
- Набор данных о понимании прочитанного
- Включает в себя вопросы, на которые можно ответить и на которые нет ответа.
- Доступен сценарий оценки
- Таблица лидеров для сравнения моделей
- Бесплатная загрузка по лицензии CC BY-SA 4.0.
Как использовать SQuAD?
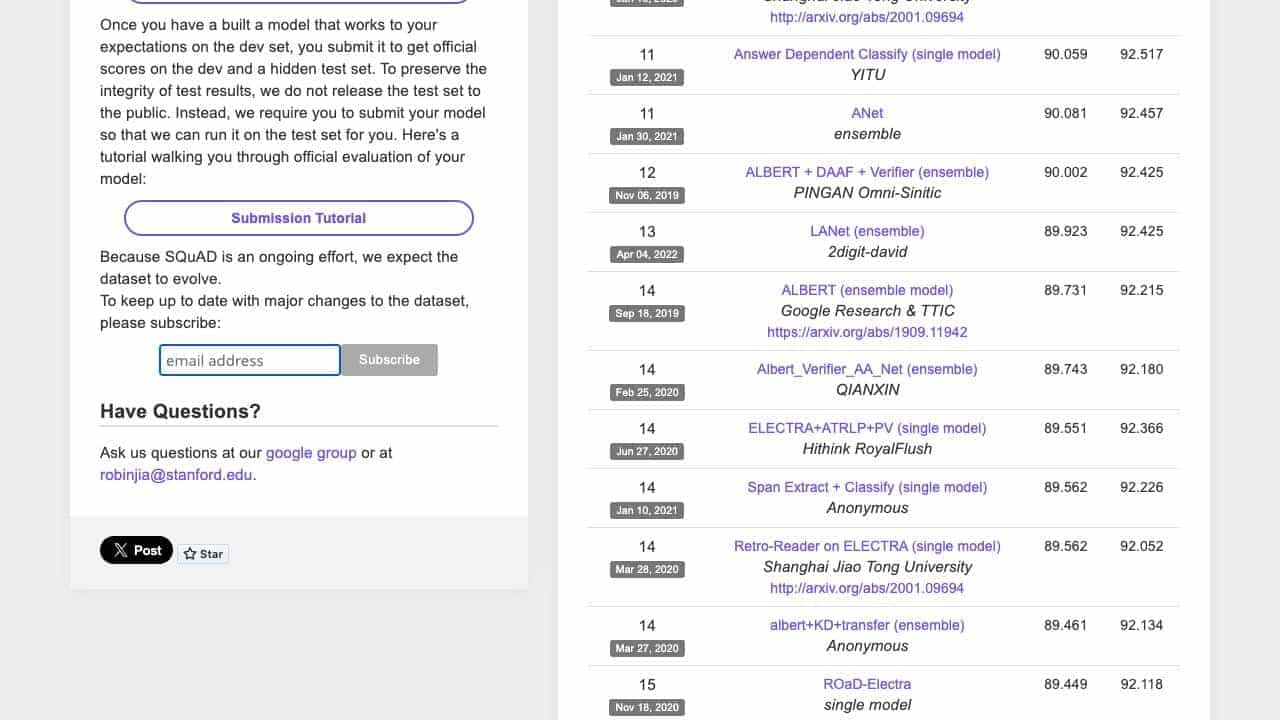
Загрузите набор данных, используйте сценарий оценки для тестирования моделей на наборах разработчиков и отправьте модели для официальной оценки на скрытых наборах тестов с помощью предоставленного руководства.
Альтернативные инструменты
Альтернативные инструменты не найдены
Преимущества & Недостатки
Преимущества
- Высококачественный эталон НЛП
- Бесплатный и с открытым исходным кодом
- Поддерживает оценку и отправку модели
- Широко используется в научных исследованиях.
Недостатки
- Ограничено английским текстом
- Для использования требуются технические знания
- Нет встроенных инструментов для обучения моделей.
Варианты использования
- Обучение моделей ИИ ответам на вопросы
- Академические исследования в НЛП
- Бенчмаркинг систем машинного обучения
Цены SQuAD
Бесплатный план
Подробная информация о ценах недоступна
Отзывы пользователей
3.0
из 5
3.0
Пока нет отзывов
Будьте первым, кто оставит отзыв об этом инструменте!