



CMU Q/A Dataset
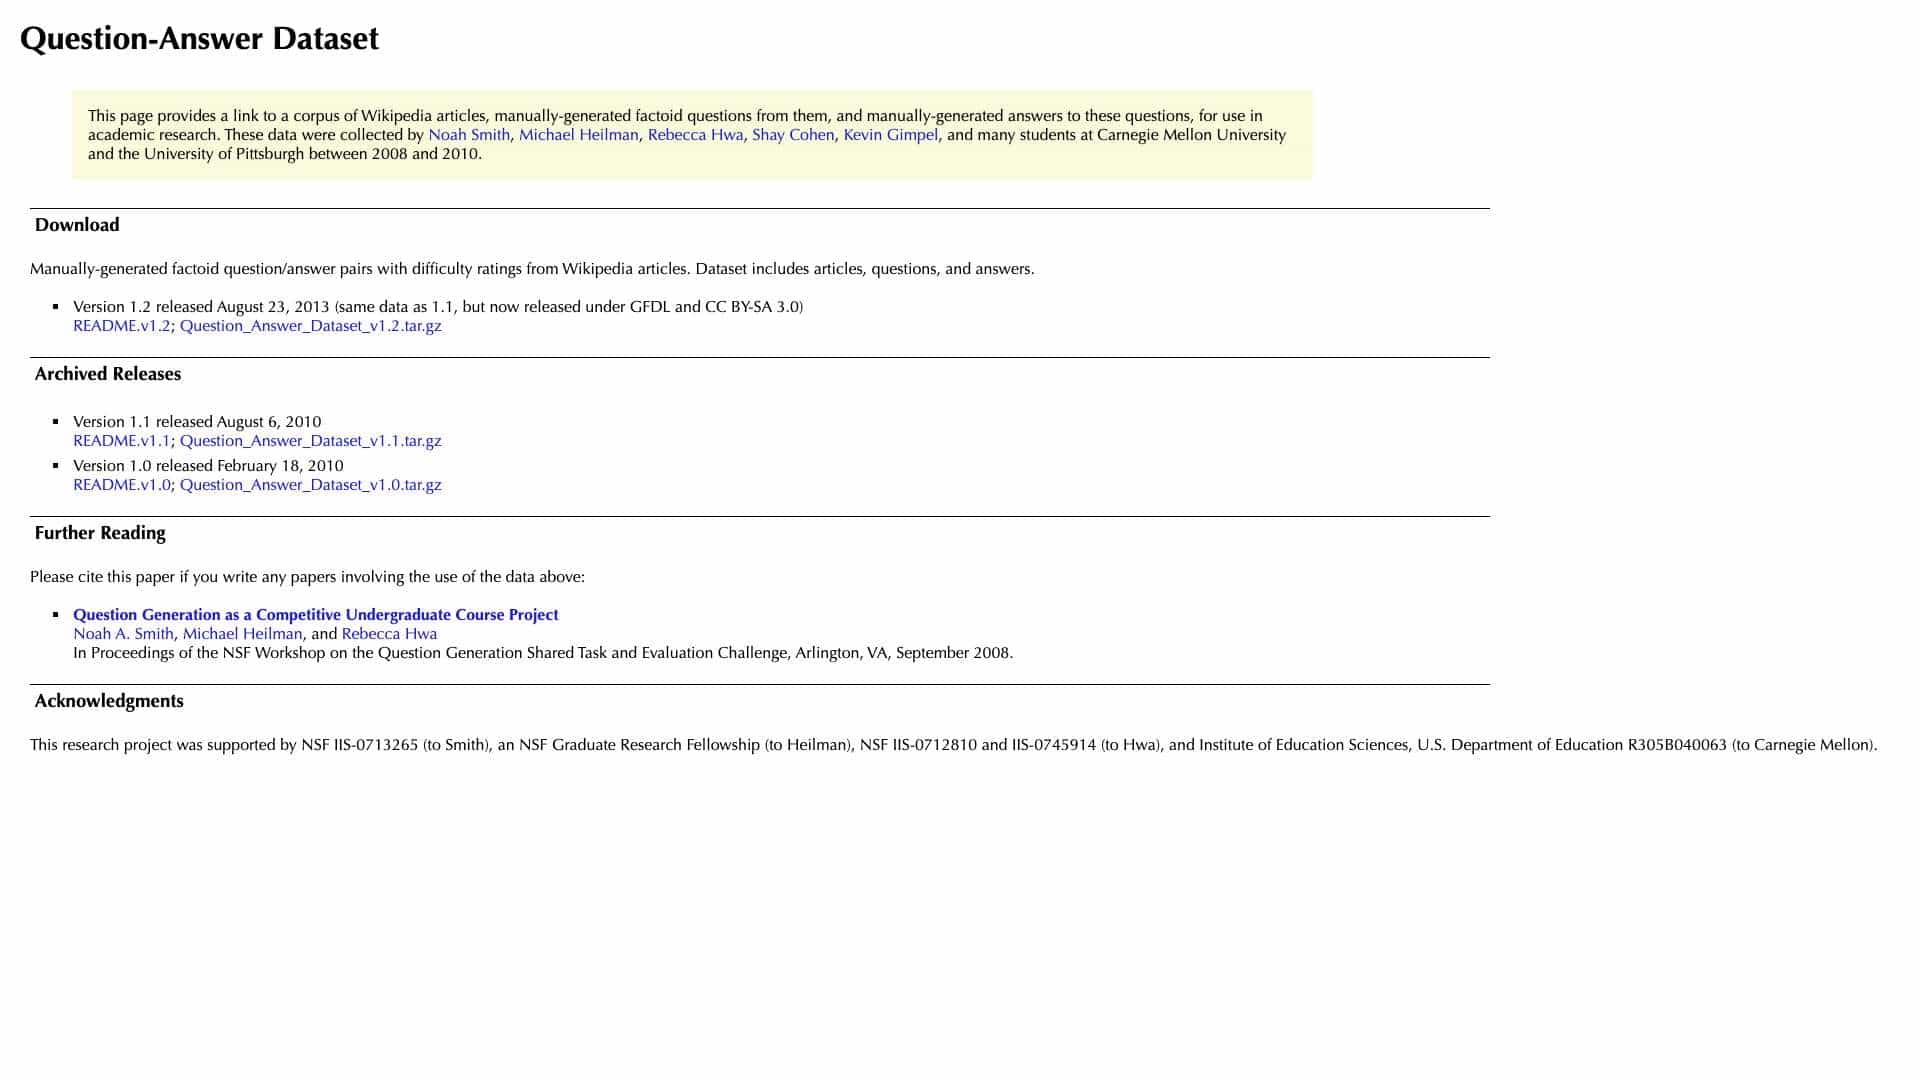
A dataset of Wikipedia articles with manually-generated factoid questions and answers for academic research, collected between 2008-2010.
Балл
30
Пользовательский рейтинг
3.0
Бесплатная/Пробная поддержка
Поддерживается
Начальная цена
--
Последнее обновление
июн. 10, 2026
Обзор
Что такое CMU Q/A Dataset?
Это корпус статей Википедии в сочетании с фактоидными вопросами и ответами, созданными вручную и предназначенными для использования в академических исследованиях по созданию вопросов и ответов. Он включает в себя рейтинги сложности и несколько версий, выпущенных под открытыми лицензиями.
Для чего используется CMU Q/A Dataset?
Основные функции
- Статьи в Википедии
- Вопросы, созданные вручную
- Ответы, созданные вручную
- Рейтинг сложности
- Доступно несколько версий
- Открытые лицензии (GFDL, CC BY-SA)
Как использовать CMU Q/A Dataset?
Загрузите файлы набора данных (например, архивы tar.gz) по предоставленным ссылкам, извлеките их и используйте статьи, вопросы и ответы для исследовательских проектов, таких как обучение или оценка моделей обработки естественного языка.
Альтернативные инструменты
Альтернативные инструменты не найдены
Преимущества & Недостатки
Преимущества
- Качественные ручные аннотации
- Полезно для исследований НЛП.
- Бесплатно скачать и использовать
- Включает научные цитаты
Недостатки
- Данные за 2008-2010 годы могут быть устаревшими.
- Ограничено фактоидными вопросами
- Нет активных обновлений или поддержки
Варианты использования
- Научные исследования по ответам на вопросы
- Обучение моделей машинного обучения
- Образовательные проекты на курсах НЛП
Цены CMU Q/A Dataset
Бесплатный план
Подробная информация о ценах недоступна
Отзывы пользователей
3.0
из 5
3.0
Пока нет отзывов
Будьте первым, кто оставит отзыв об этом инструменте!