



Spark SQL
Módulo do Apache Spark para consulta de dados estruturados usando SQL ou API DataFrame, integrado a programas Spark e com suporte a múltiplas fontes de dados.
Pontuação
30
Avaliação do Usuário
3.0
Suporte Gratuito/Teste
Não Suportado
Preço Inicial
--
Última Atualização
ago 04, 2026
Visão geral
O que é Spark SQL?
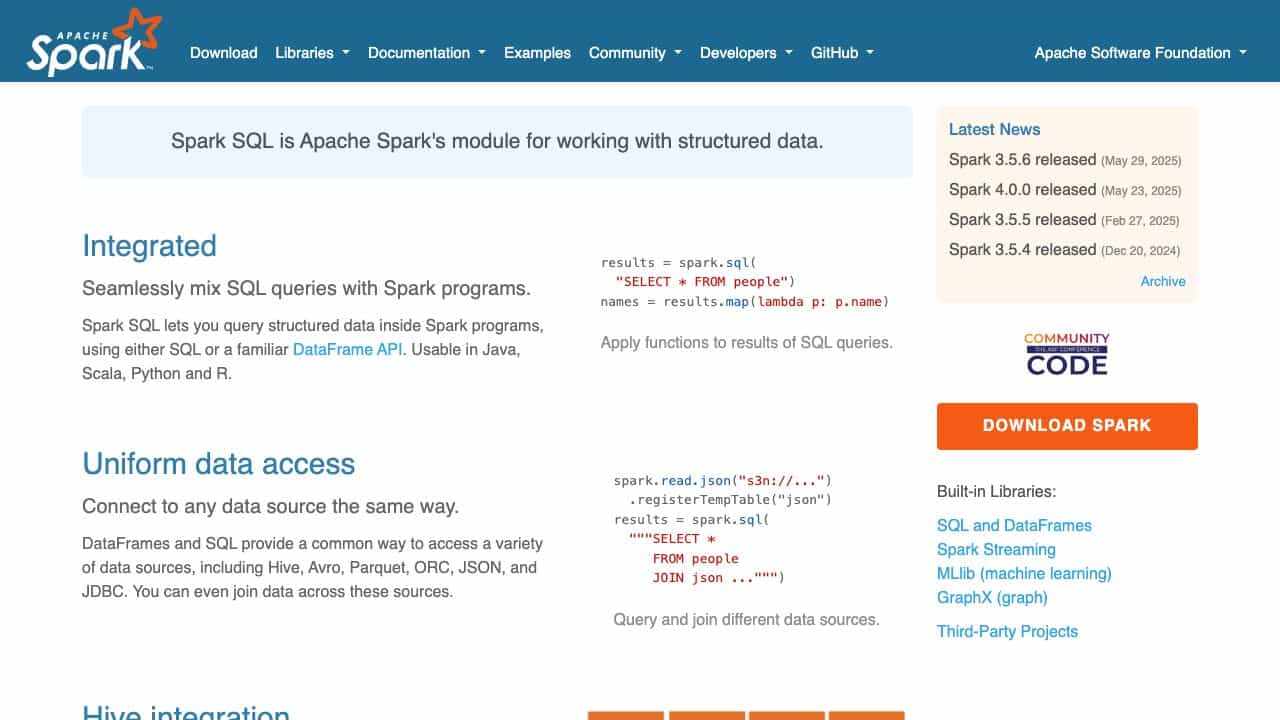
Spark SQL é um módulo do Apache Spark projetado para processar dados estruturados. Ele permite que os usuários executem consultas SQL perfeitamente em aplicativos Spark, usando sintaxe SQL ou uma API DataFrame. Ele oferece suporte à integração com várias fontes de dados, como Hive, JSON, Parquet e JDBC/ODBC, e inclui recursos de desempenho, como otimização baseada em custos e armazenamento colunar.
Para que serve o Spark SQL?
Principais Recursos
- Consultas SQL integradas com programas Spark
- Acesso uniforme aos dados em diversas fontes
- Integração do Hive para armazéns existentes
- Conectividade JDBC/ODBC para ferramentas de BI
- Otimização de desempenho com otimizador baseado em custos e armazenamento colunar
Como usar Spark SQL?
Baixe o Apache Spark, que inclui o Spark SQL. Use o guia Spark SQL ou DataFrame para aprender a API. Escreva consultas em SQL ou use a API DataFrame em Java, Scala, Python ou R para acessar e unir dados de várias fontes, como Hive, JSON ou JDBC.
Ferramentas Alternativas
Nenhuma ferramenta alternativa encontrada
Prós & Contras
Prós
- Integração perfeita com Spark
- Suporta múltiplas linguagens de programação
- Alta escalabilidade e tolerância a falhas
- Gratuito e de código aberto sob licença Apache
Contras
- Requer aprendizado do ecossistema Spark
- Pode ter uma curva de aprendizado acentuada para iniciantes
Casos de Uso
- Análise e consulta de big data
- Integração de dados de diversas fontes
- Relatórios de inteligência de negócios
- Pré-processamento de dados de aprendizado de máquina
Avaliações de Usuários
3.0
de 5
3.0
Ainda não há avaliações
Seja o primeiro a avaliar esta ferramenta!