



CMU Q/A Dataset
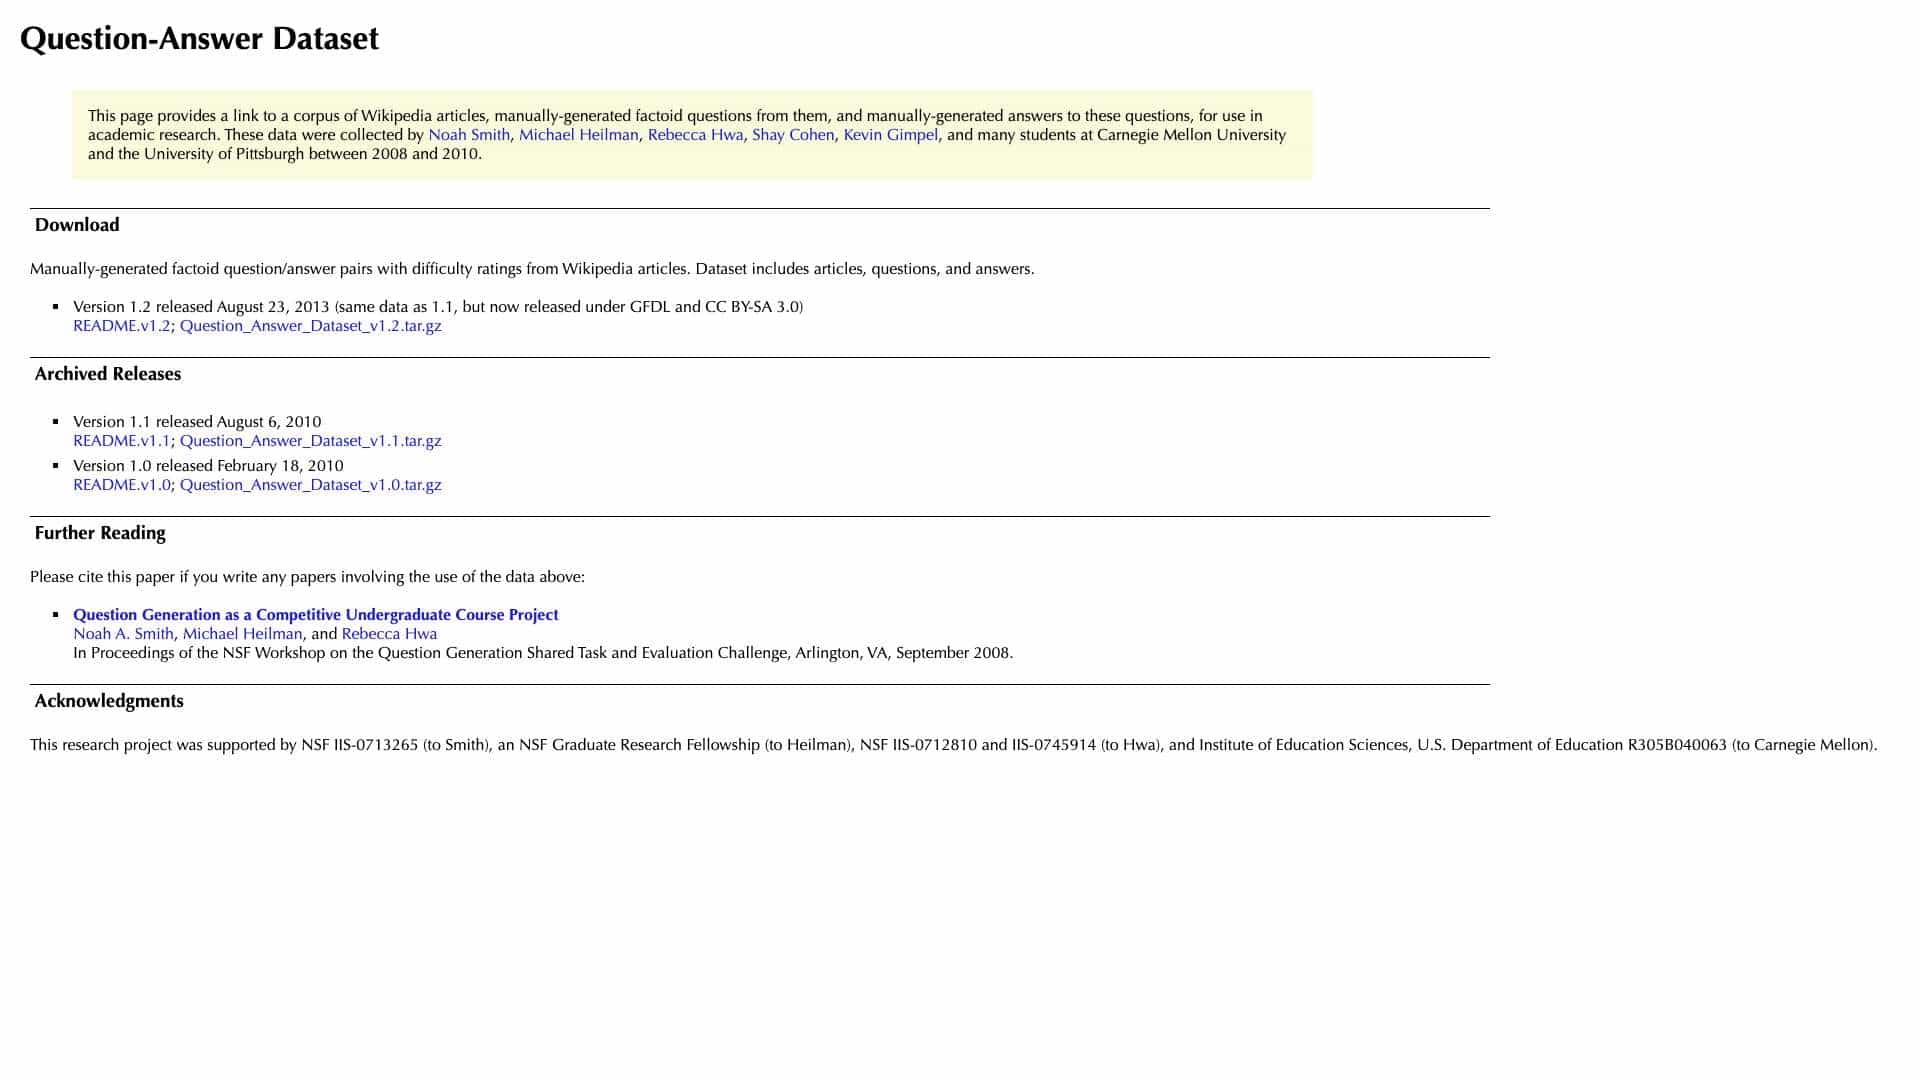
Um conjunto de dados de artigos da Wikipédia com perguntas e respostas factóides geradas manualmente para pesquisas acadêmicas, coletados entre 2008-2010.
Pontuação
30
Avaliação do Usuário
3.0
Suporte Gratuito/Teste
Suportado
Preço Inicial
--
Última Atualização
mai 02, 2026
Visão geral
O que é CMU Q/A Dataset?
Este é um corpus de artigos da Wikipedia combinados com perguntas e respostas factóides criadas manualmente, projetados para uso em pesquisas acadêmicas sobre geração e resposta de perguntas. Inclui classificações de dificuldade e múltiplas versões lançadas sob licenças abertas.
Para que serve o CMU Q/A Dataset?
Principais Recursos
- Artigos da Wikipédia
- Perguntas geradas manualmente
- Respostas geradas manualmente
- Avaliações de dificuldade
- Várias versões disponíveis
- Licenças abertas (GFDL, CC BY-SA)
Como usar CMU Q/A Dataset?
Baixe os arquivos do conjunto de dados (por exemplo, arquivos tar.gz) dos links fornecidos, extraia-os e use os artigos, perguntas e respostas para projetos de pesquisa, como treinamento ou avaliação de modelos de processamento de linguagem natural.
Ferramentas Alternativas
Nenhuma ferramenta alternativa encontrada
Prós & Contras
Prós
- Anotações manuais de alta qualidade
- Útil para pesquisa de PNL
- Gratuito para baixar e usar
- Inclui citações acadêmicas
Contras
- Os dados de 2008-2010 podem estar desatualizados
- Limitado a questões factóides
- Nenhuma atualização ou suporte ativo
Casos de Uso
- Pesquisa acadêmica sobre resposta a perguntas
- Treinamento de modelos de aprendizado de máquina
- Projetos educacionais em cursos de PNL
Preços do CMU Q/A Dataset
Plano Gratuito
Nenhuma informação detalhada de preços disponível
Avaliações de Usuários
3.0
de 5
3.0
Ainda não há avaliações
Seja o primeiro a avaliar esta ferramenta!