



ApacheTajo
Apache Tajo é um sistema distribuído de big data warehouse no Hadoop para consultas SQL de baixa latência, ETL e processamento de dados escalonável.
Pontuação
30
Avaliação do Usuário
3.0
Suporte Gratuito/Teste
Não Suportado
Preço Inicial
--
Última Atualização
ago 04, 2026
Visão geral
O que é ApacheTajo?
Apache Tajo é um sistema robusto de big data relacional e de data warehouse distribuído projetado para Apache Hadoop. Ele oferece suporte a padrões SQL, permite consultas ad hoc de baixa latência, agregação on-line e ETL em grandes conjuntos de dados armazenados em HDFS e outras fontes, com otimização avançada de consultas e tolerância a falhas.
Para que serve o ApacheTajo?
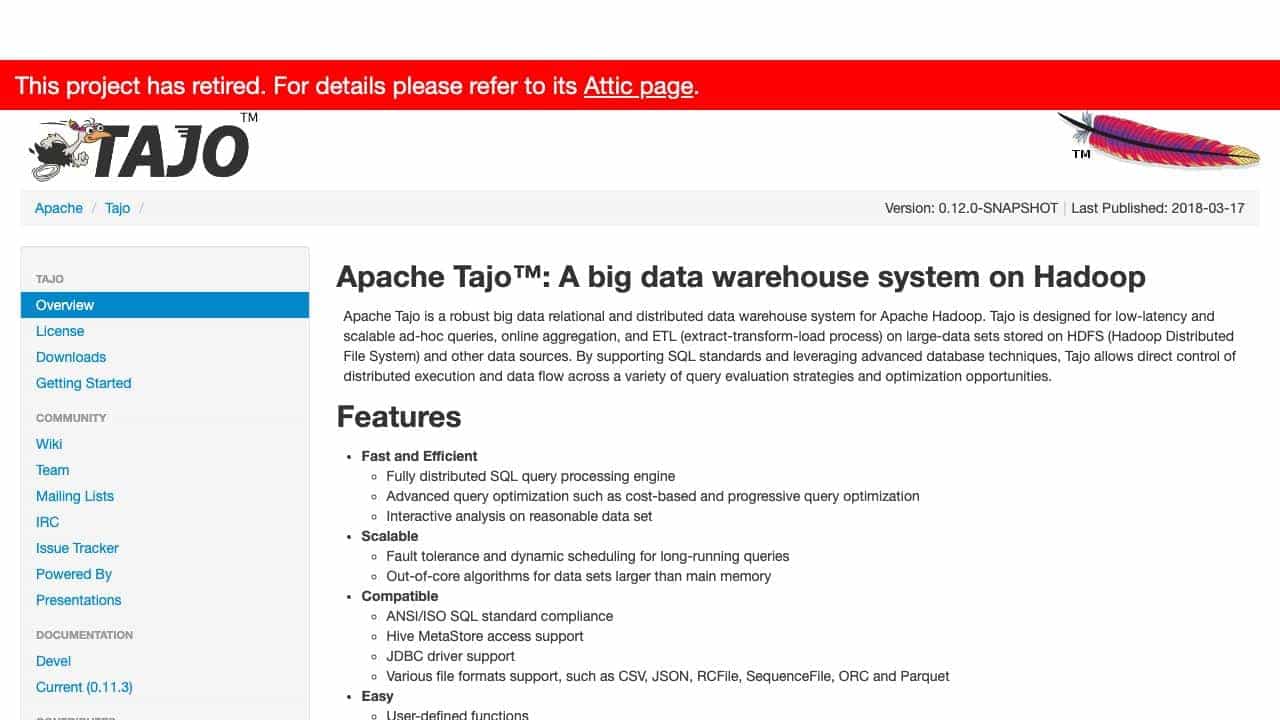
Principais Recursos
- Processamento distribuído de consultas SQL
- Otimização avançada de consultas
- Tolerância a falhas e agendamento dinâmico
- Conformidade ANSI/ISO SQL
- Suporte para vários formatos de arquivo
- Funções definidas pelo usuário
- Concha interativa
- Suporte ao driver JDBC
Como usar ApacheTajo?
Implante Tajo em clusters Hadoop, use SQL para consultar dados, aproveite JDBC para conectividade e utilize seu shell interativo e APIs para processamento e análise de dados em conjuntos de big data.
Ferramentas Alternativas
Nenhuma ferramenta alternativa encontrada
Prós & Contras
Prós
- Escalável para big data
- Consultas de baixa latência
- Código aberto e gratuito
- Compatível com ecossistema Hadoop
- Suporta múltiplas fontes de dados
Contras
- Projeto retirado (sem desenvolvimento ativo)
- Requer infraestrutura Hadoop
- Curva de aprendizado íngreme para iniciantes
Casos de Uso
- Análise e relatórios de big data
- Processos ETL no Hadoop
- Exploração interativa de dados
- Armazenamento de dados para empresas
Avaliações de Usuários
3.0
de 5
3.0
Ainda não há avaliações
Seja o primeiro a avaliar esta ferramenta!