



CMU Q/A Dataset
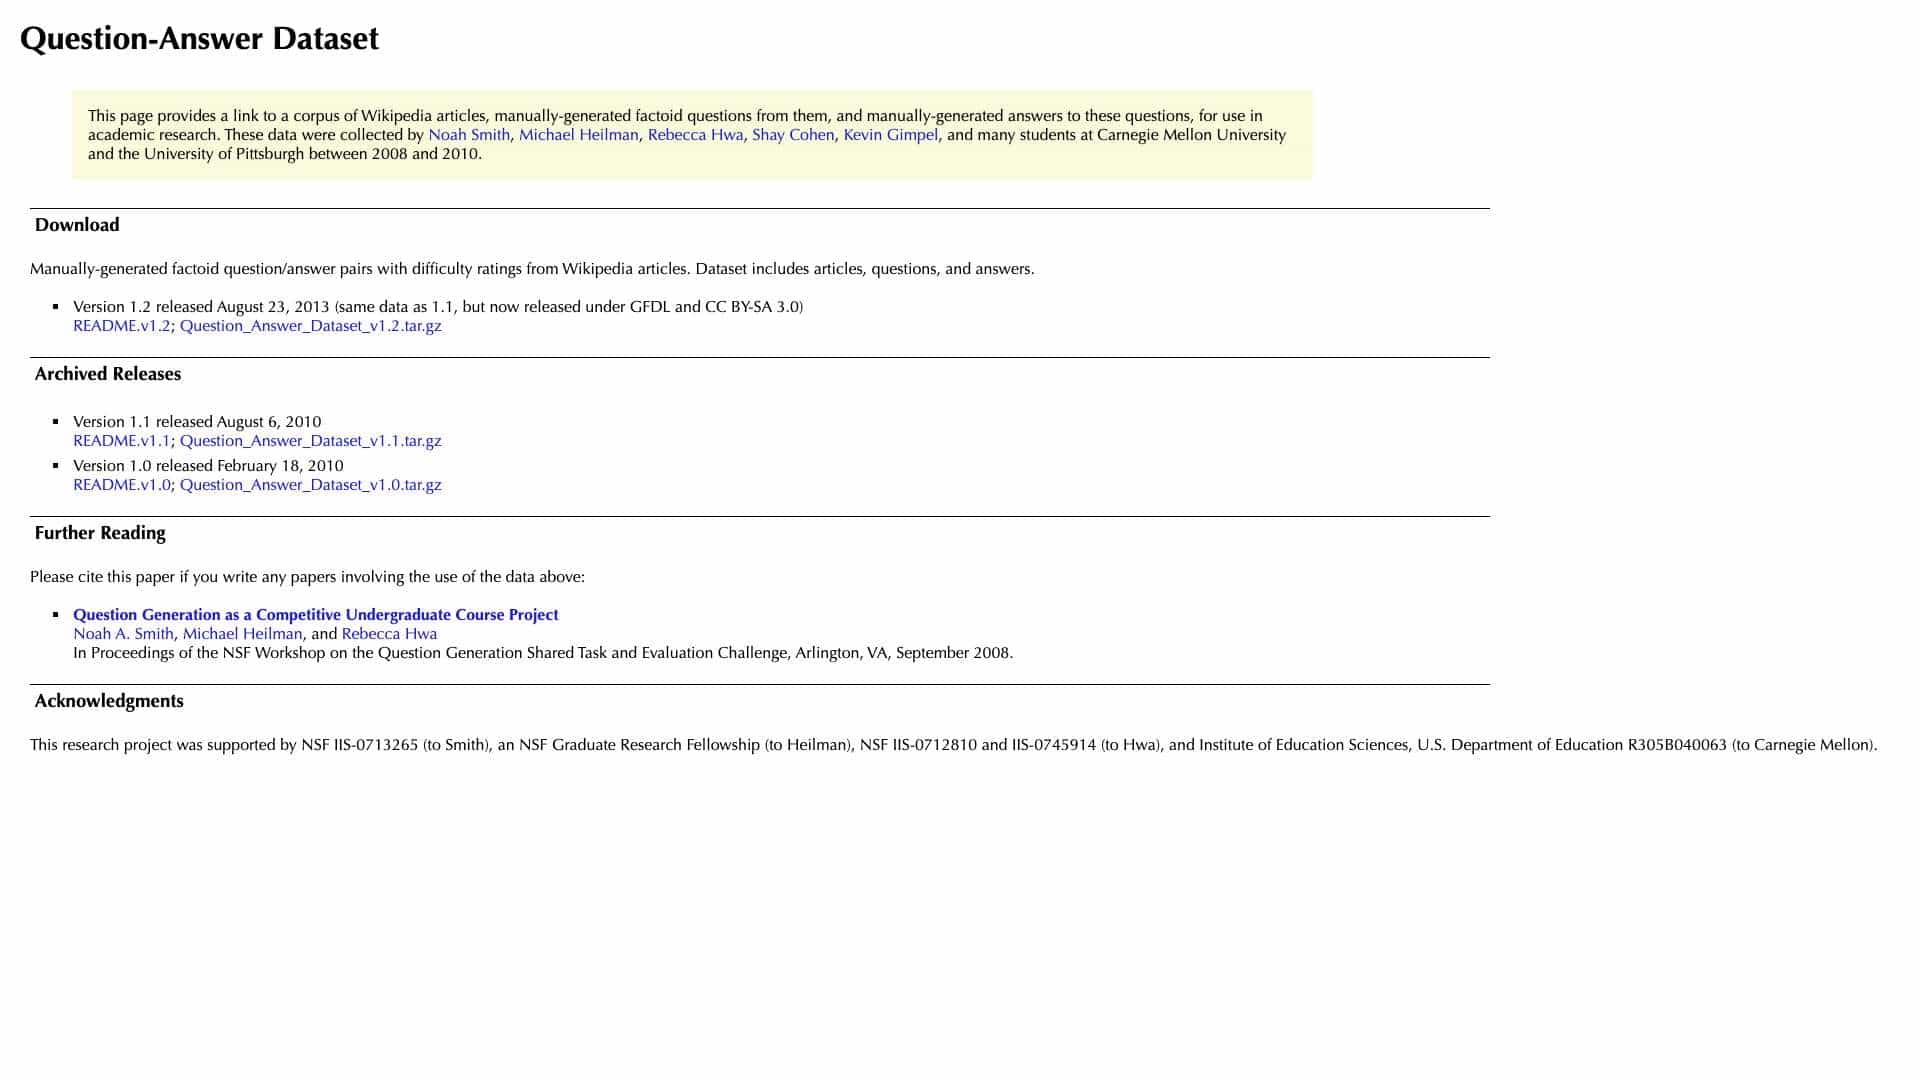
2008년부터 2010년 사이에 수집된 학술 연구를 위해 수동으로 생성된 사실적 질문과 답변이 포함된 Wikipedia 기사의 데이터세트입니다.
점수
30
사용자 평가
3.0
무료/체험 지원
지원됨
시작 가격
--
마지막 업데이트
5월 02, 2026
개요
CMU Q/A Dataset이란?
이것은 수동으로 생성된 사실적 질문 및 답변과 짝을 이루는 Wikipedia 기사 모음으로, 질문 생성 및 답변에 대한 학문적 연구에 사용하도록 설계되었습니다. 여기에는 난이도 등급과 오픈 라이센스로 출시된 여러 버전이 포함됩니다.
CMU Q/A Dataset은 무엇에 사용되나요?
주요 기능
- 위키피디아 기사
- 수동으로 생성된 질문
- 수동으로 생성된 답변
- 난이도 등급
- 여러 버전 사용 가능
- 오픈 라이선스(GFDL, CC BY-SA)
CMU Q/A Dataset 사용 방법은?
제공된 링크에서 데이터 세트 파일(예: tar.gz 아카이브)을 다운로드하고 추출한 후 자연어 처리 모델 교육 또는 평가와 같은 연구 프로젝트에 대한 기사, 질문 및 답변을 사용하세요.
대안 도구
대안 도구를 찾을 수 없습니다
장점 & 단점
장점
- 고품질 수동 주석
- NLP 연구에 유용함
- 무료로 다운로드하여 사용할 수 있습니다.
- 학술 인용 포함
단점
- 2008~2010년 데이터는 오래되었을 수 있습니다.
- 사실에 관한 질문으로 제한됨
- 활성 업데이트나 지원이 없습니다.
사용 사례
- 질의응답에 관한 학술연구
- 머신러닝 모델 훈련
- NLP 과정의 교육 프로젝트
CMU Q/A Dataset 가격
무료 플랜
상세 가격 정보가 없습니다
사용자 리뷰
3.0
5점 만점
3.0
아직 리뷰가 없습니다
이 도구의 첫 번째 리뷰어가 되세요!