



Billion Words
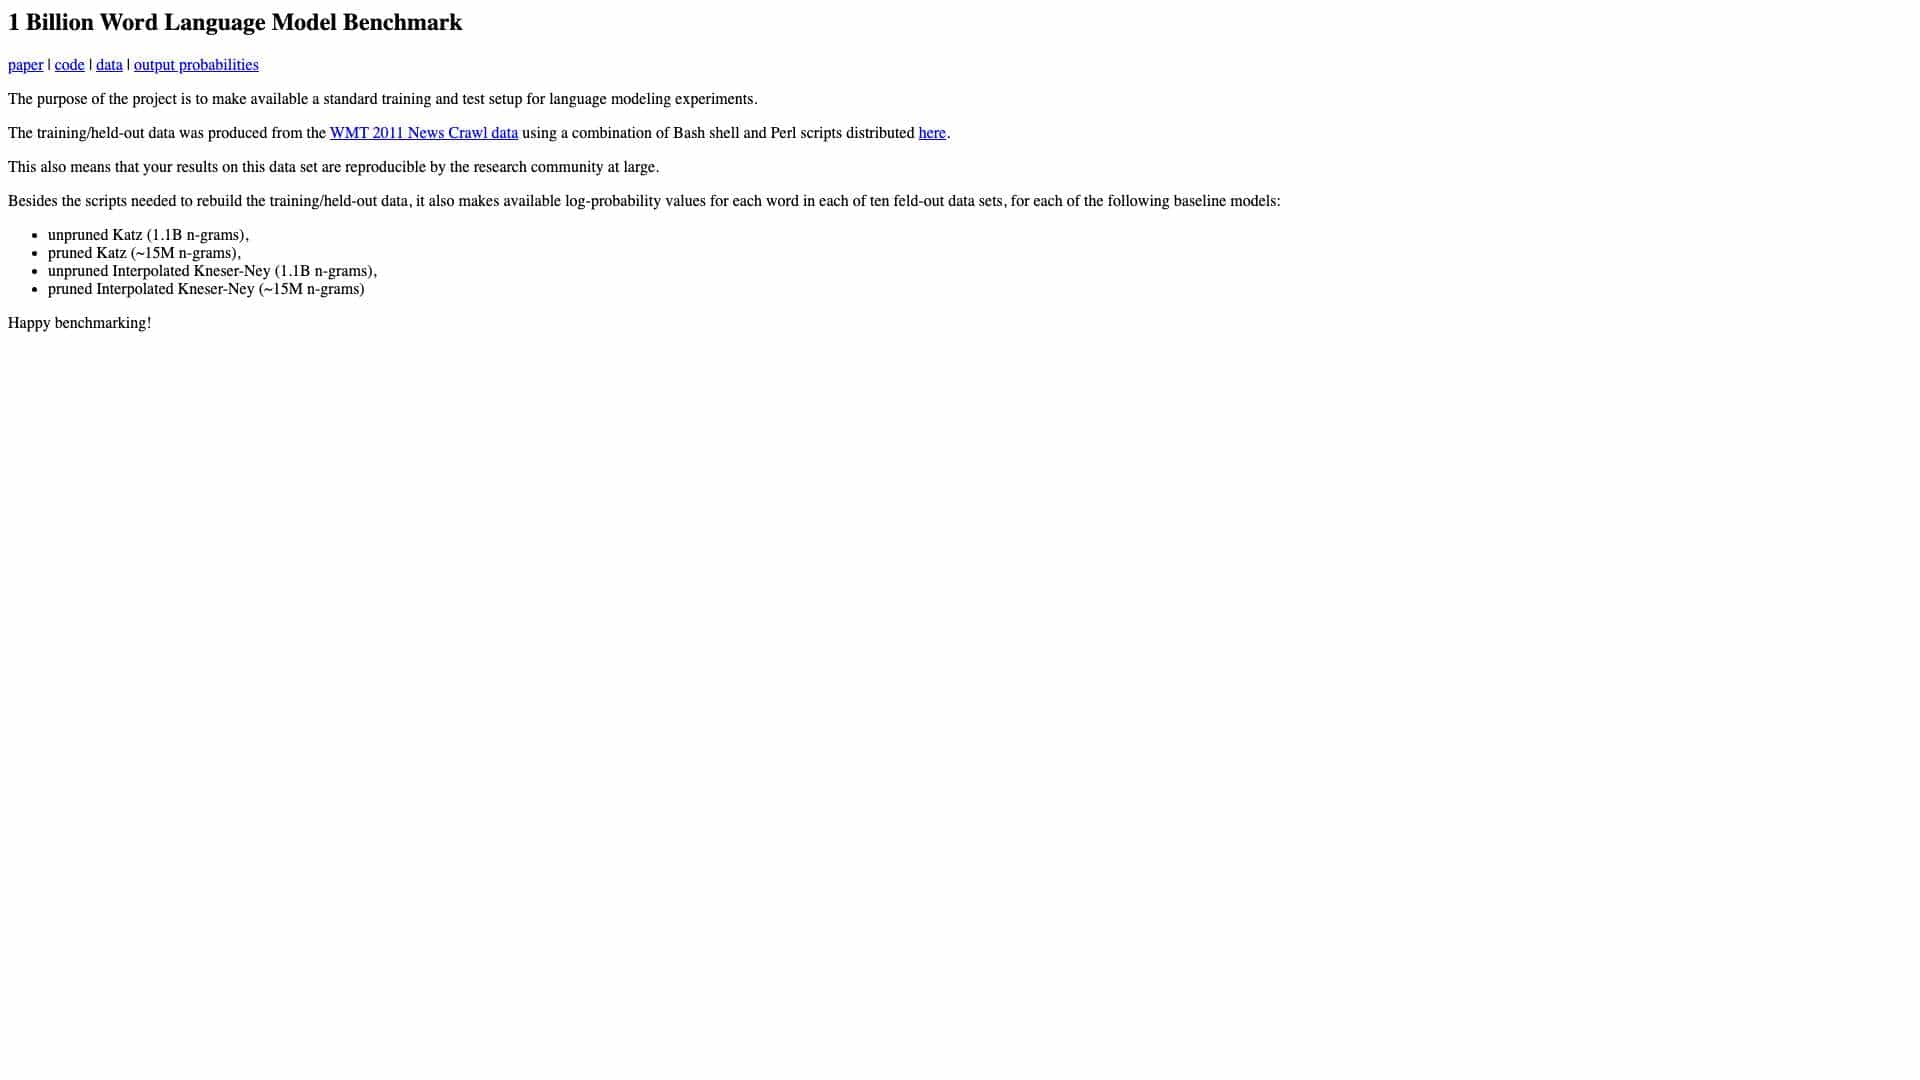
10억 단어로 이루어진 언어 모델링 실험을 위한 벤치마크 데이터 세트로, 재현 가능한 연구를 위한 훈련/테스트 데이터와 기본 모델 출력을 제공합니다.
점수
30
사용자 평가
3.0
무료/체험 지원
지원되지 않음
시작 가격
--
마지막 업데이트
8월 04, 2026
개요
Billion Words이란?
Billion Words 프로젝트는 WMT 2011 News Crawl 데이터를 사용하여 언어 모델링을 위한 표준 교육 및 테스트 설정을 제공합니다. 여기에는 Katz 및 Kneser-Ney와 같은 기준 모델에 대한 데이터 및 로그 확률 값을 재구성하는 스크립트가 포함되어 있어 NLP 연구에서 재현 가능한 벤치마킹이 가능합니다.
Billion Words은 무엇에 사용되나요?
주요 기능
- 10억 단어 데이터세트
- 훈련 및 테스트 데이터
- 기준 모델 출력
- 재현 가능한 스크립트
Billion Words 사용 방법은?
제공된 스크립트와 데이터를 다운로드하여 언어 모델링 실험을 설정하세요. 모델 개발을 위한 훈련 데이터와 테스트를 위한 보유 데이터를 사용하고 사용 가능한 로그 확률 출력을 사용하여 기본 모델과 결과를 비교합니다.
대안 도구
대안 도구를 찾을 수 없습니다
장점 & 단점
장점
- 표준화된 벤치마크
- 재현 가능한 결과
- 무료 및 오픈 소스
- 다양한 모델 지원
단점
- 기술적인 설정이 필요합니다
- 특정 데이터 소스로 제한됨
사용 사례
- NLP 연구 벤치마킹
- 언어 모델 개발
- 학술 실험
사용자 리뷰
3.0
5점 만점
3.0
아직 리뷰가 없습니다
이 도구의 첫 번째 리뷰어가 되세요!