



ApacheTajo
Apache Tajo는 대기 시간이 짧은 SQL 쿼리, ETL 및 확장 가능한 데이터 처리를 위한 Hadoop의 분산형 빅 데이터 웨어하우스 시스템입니다.
점수
30
사용자 평가
3.0
무료/체험 지원
지원되지 않음
시작 가격
--
마지막 업데이트
8월 04, 2026
개요
ApacheTajo이란?
Apache Tajo는 Apache Hadoop용으로 설계된 강력한 빅 데이터 관계형 및 분산 데이터 웨어하우스 시스템입니다. 이는 SQL 표준을 지원하고 고급 쿼리 최적화 및 내결함성을 통해 HDFS 및 기타 소스에 저장된 대규모 데이터 세트에 대한 대기 시간이 짧은 임시 쿼리, 온라인 집계 및 ETL을 지원합니다.
ApacheTajo은 무엇에 사용되나요?
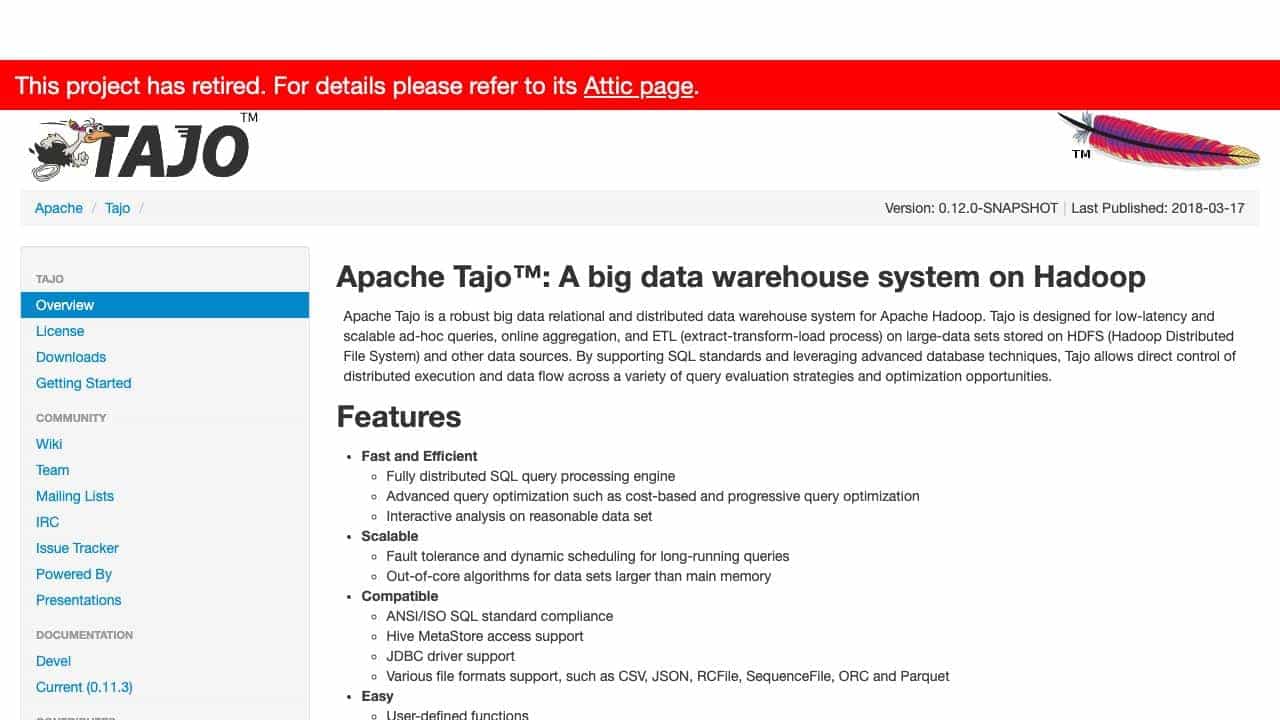
주요 기능
- 분산 SQL 쿼리 처리
- 고급 쿼리 최적화
- 내결함성 및 동적 스케줄링
- ANSI/ISO SQL 준수
- 다양한 파일 형식 지원
- 사용자 정의 함수
- 대화형 쉘
- JDBC 드라이버 지원
ApacheTajo 사용 방법은?
Hadoop 클러스터에 Tajo를 배포하고, 데이터 쿼리에 SQL을 사용하고, 연결을 위해 JDBC를 활용하고, 빅 데이터 세트에 대한 데이터 처리 및 분석을 위해 대화형 셸 및 API를 활용합니다.
대안 도구
대안 도구를 찾을 수 없습니다
장점 & 단점
장점
- 빅데이터에 맞게 확장 가능
- 지연 시간이 짧은 쿼리
- 오픈 소스 및 무료
- Hadoop 생태계와 호환 가능
- 여러 데이터 소스 지원
단점
- 폐기된 프로젝트(활성 개발 없음)
- Hadoop 인프라 필요
- 초보자를 위한 가파른 학습 곡선
사용 사례
- 빅데이터 분석 및 보고
- Hadoop의 ETL 프로세스
- 대화형 데이터 탐색
- 기업을 위한 데이터 웨어하우징
사용자 리뷰
3.0
5점 만점
3.0
아직 리뷰가 없습니다
이 도구의 첫 번째 리뷰어가 되세요!