



CMU Q/A Dataset
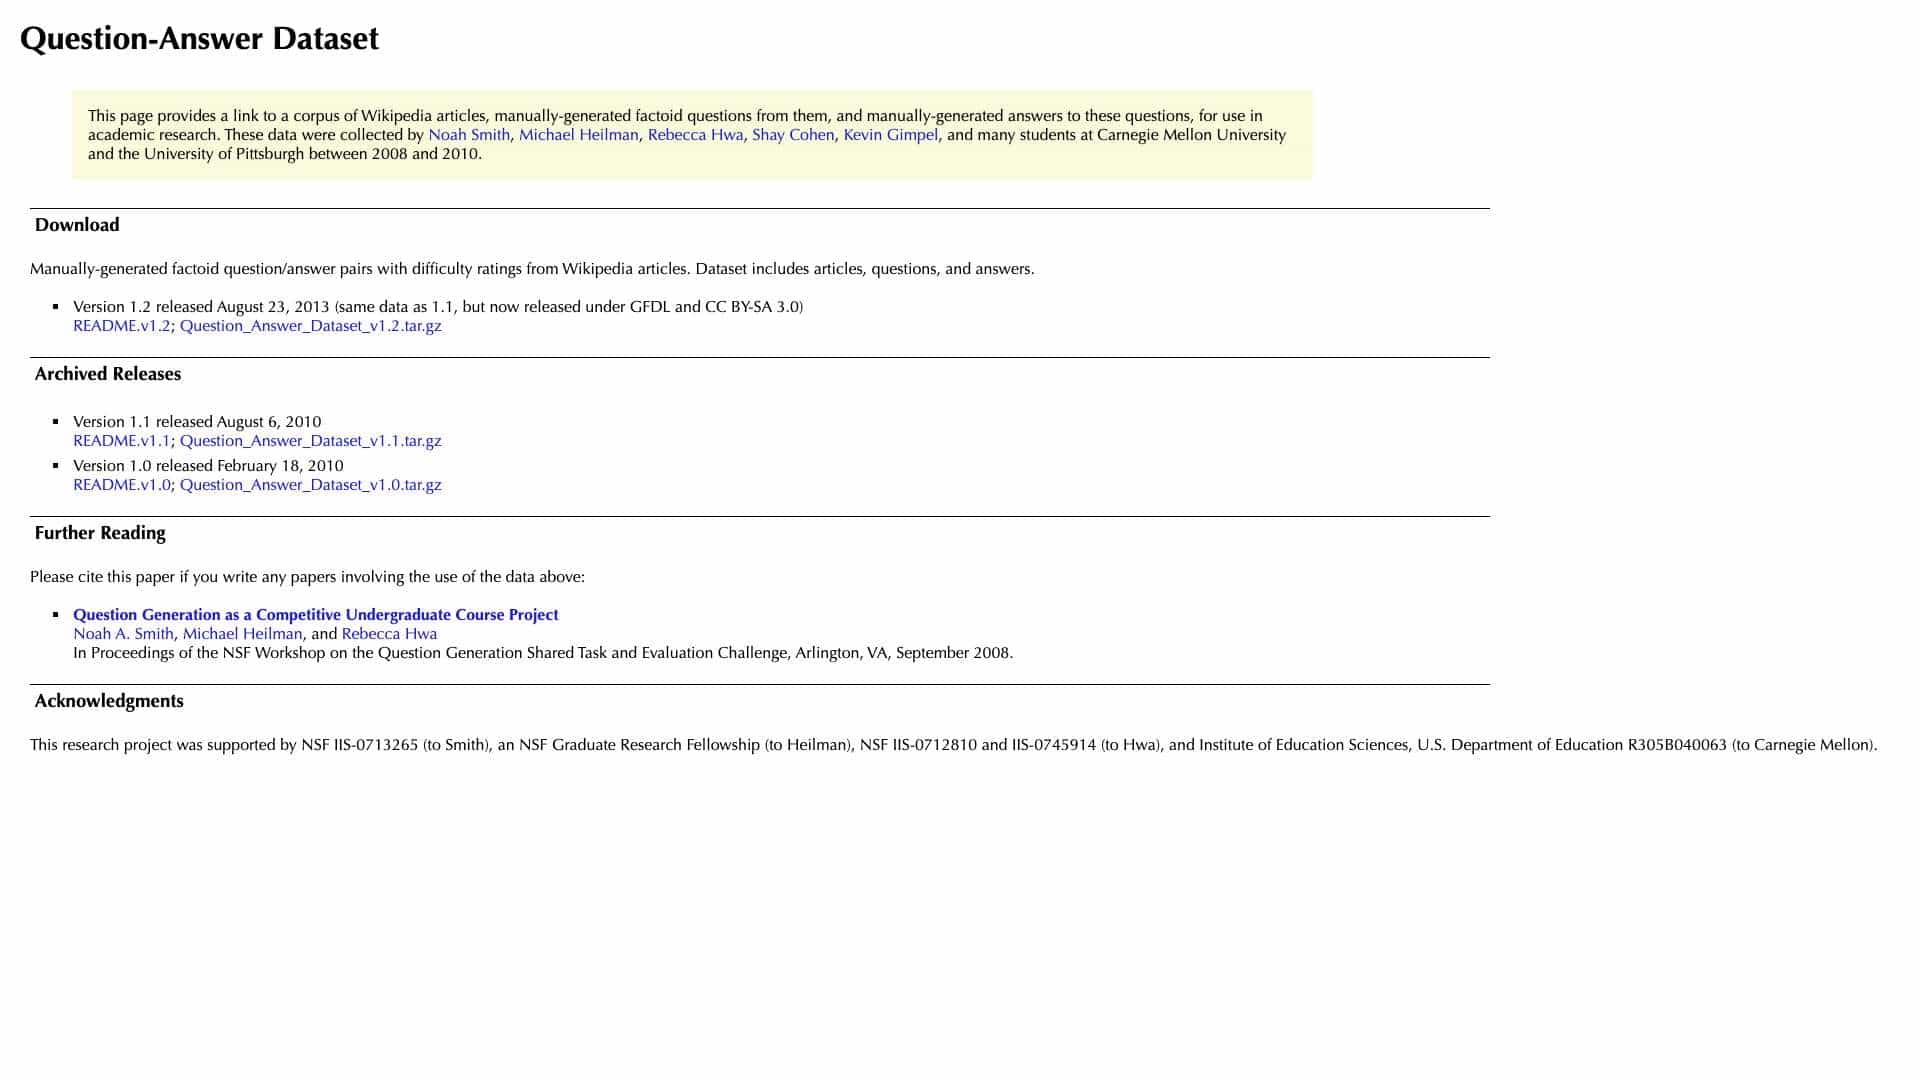
2008 年から 2010 年の間に収集された、学術研究のために手動で生成された事実上の質問と回答を含む Wikipedia 記事のデータセット。
スコア
30
ユーザー評価
3.0
無料/トライアルサポート
サポート済み
開始価格
--
最終更新
5月 02, 2026
概要
CMU Q/A Datasetとは?
これは、手動で作成された事実上の質問と回答を組み合わせた Wikipedia 記事のコーパスであり、質問の生成と回答に関する学術研究で使用するために設計されています。これには、難易度の評価と、オープン ライセンスの下でリリースされた複数のバージョンが含まれています。
CMU Q/A Datasetは何に使われますか?
主要機能
- ウィキペディアの記事
- 手動で生成された質問
- 手動で生成された回答
- 難易度の評価
- 複数のバージョンが利用可能
- オープンライセンス (GFDL、CC BY-SA)
CMU Q/A Datasetの使い方は?
提供されたリンクからデータセット ファイル (tar.gz アーカイブなど) をダウンロードして抽出し、記事、質問、回答を自然言語処理モデルのトレーニングや評価などの研究プロジェクトに使用します。
代替ツール
代替ツールが見つかりません
メリット & デメリット
メリット
- 高品質の手動注釈
- NLPの研究に役立つ
- 無料でダウンロードして使用できます
- 学術的な引用を含む
デメリット
- 2008 年から 2010 年のデータは古い可能性があります
- 事実に関する質問に限定される
- アクティブなアップデートやサポートはありません
使用例
- 質問応答に関する学術研究
- 機械学習モデルのトレーニング
- NLP コースの教育プロジェクト
CMU Q/A Datasetの料金
無料プラン
詳細な料金情報がありません
ユーザーレビュー
3.0
5点中
3.0
まだレビューがありません
このツールの最初のレビュアーになりましょう!