



Billion Words
10 億単語を含む言語モデリング実験用のベンチマーク データセット。再現可能な研究のためのトレーニング/テスト データとベースライン モデル出力を提供します。
スコア
30
ユーザー評価
3.0
無料/トライアルサポート
サポート対象外
開始価格
--
最終更新
8月 04, 2026
概要
Billion Wordsとは?
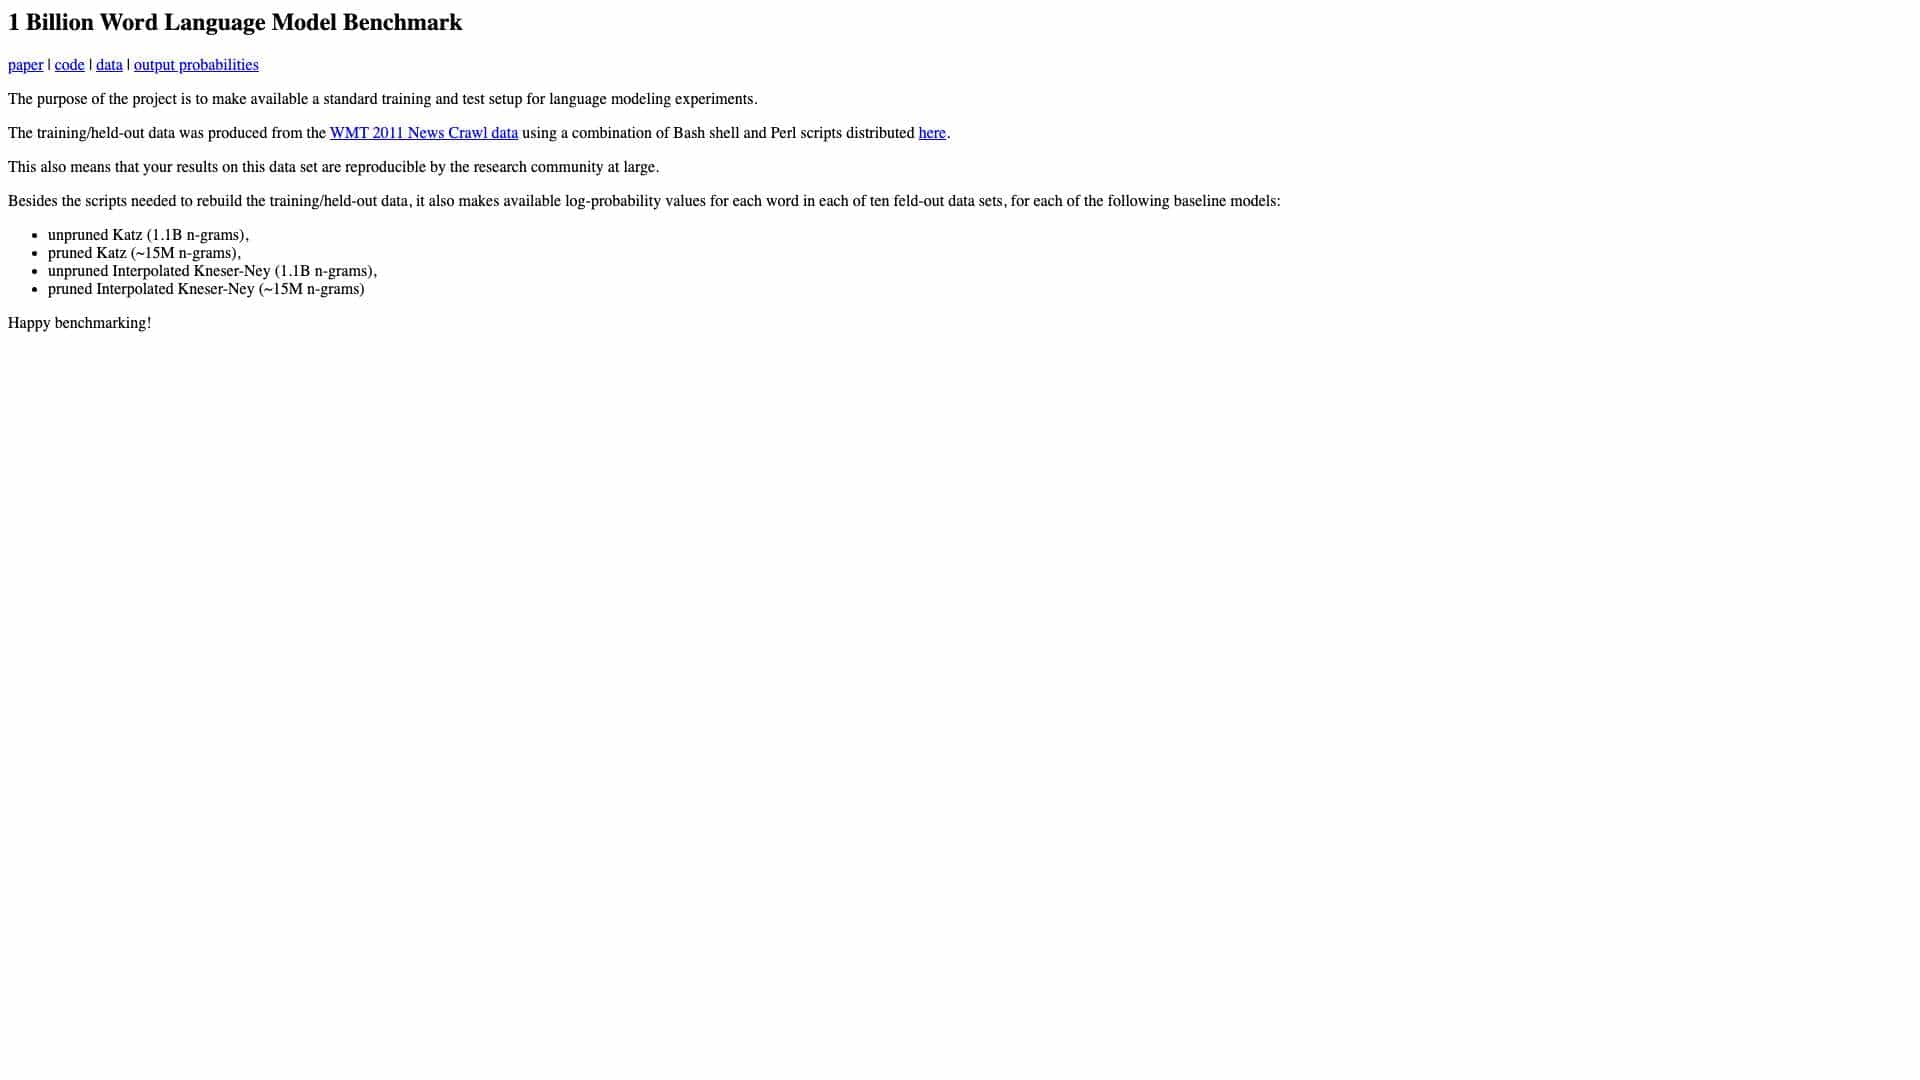
Billion Words プロジェクトは、WMT 2011 ニュース クロール データを使用した、言語モデリングの標準的なトレーニングとテストのセットアップを提供します。これには、Katz や Kneser-Ney などのベースライン モデルのデータと対数確率値を再構築するスクリプトが含まれており、NLP 研究で再現可能なベンチマークを可能にします。
Billion Wordsは何に使われますか?
主要機能
- 10億語のデータセット
- トレーニングとテストのデータ
- ベースラインモデルの出力
- 再現可能なスクリプト
Billion Wordsの使い方は?
提供されたスクリプトとデータをダウンロードして、言語モデリングの実験をセットアップします。トレーニング データをモデル開発に使用し、保持されたデータをテストに使用し、利用可能な対数確率出力を使用して結果をベースライン モデルと比較します。
代替ツール
代替ツールが見つかりません
メリット & デメリット
メリット
- 標準化されたベンチマーク
- 再現可能な結果
- 無料かつオープンソース
- 複数のモデルをサポート
デメリット
- 技術的なセットアップが必要です
- 特定のデータソースに限定される
使用例
- NLP 研究のベンチマーク
- 言語モデルの開発
- 学術実験
ユーザーレビュー
3.0
5点中
3.0
まだレビューがありません
このツールの最初のレビュアーになりましょう!