



ApacheTajo
Apache Tajo は、低遅延 SQL クエリ、ETL、およびスケーラブルなデータ処理を実現する、Hadoop 上の分散ビッグ データ ウェアハウス システムです。
スコア
30
ユーザー評価
3.0
無料/トライアルサポート
サポート対象外
開始価格
--
最終更新
8月 04, 2026
概要
ApacheTajoとは?
Apache Tajo は、Apache Hadoop 用に設計された堅牢なビッグ データ リレーショナルおよび分散データ ウェアハウス システムです。 SQL 標準をサポートし、高度なクエリ最適化とフォールト トレランスを備えた、HDFS やその他のソースに保存されている大規模なデータセットに対する低遅延のアドホック クエリ、オンライン集計、ETL を可能にします。
ApacheTajoは何に使われますか?
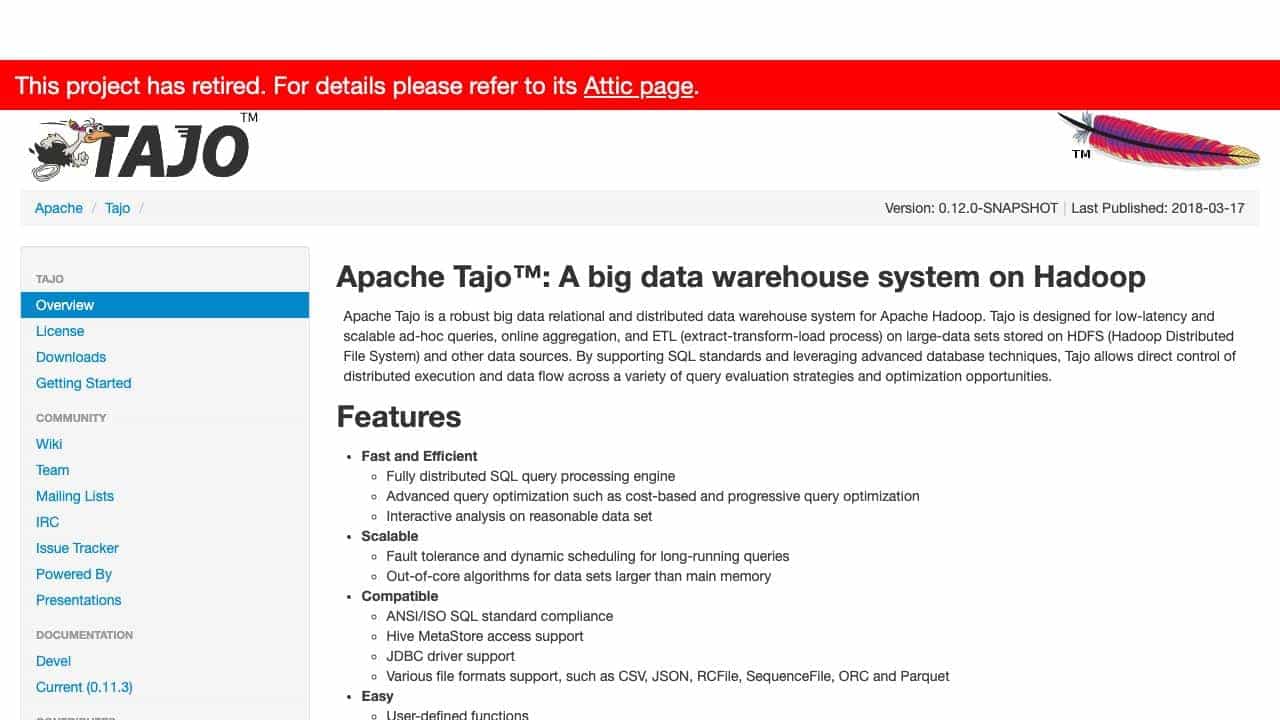
主要機能
- 分散SQLクエリ処理
- 高度なクエリの最適化
- フォールトトレランスと動的スケジューリング
- ANSI/ISO SQL 準拠
- さまざまなファイル形式のサポート
- ユーザー定義関数
- インタラクティブシェル
- JDBCドライバーのサポート
ApacheTajoの使い方は?
TajoをHadoopクラスタに展開し、データのクエリにSQLを使用し、接続にJDBCを利用し、ビッグデータセットのデータ処理と分析に対話型シェルとAPIを利用します。
代替ツール
代替ツールが見つかりません
メリット & デメリット
メリット
- ビッグデータに対応したスケーラビリティ
- 低レイテンシーのクエリ
- オープンソースで無料
- Hadoopエコシステムとの互換性
- 複数のデータソースをサポート
デメリット
- 廃止されたプロジェクト (アクティブな開発はありません)
- Hadoopインフラストラクチャが必要
- 初心者にとって急な学習曲線
使用例
- ビッグデータの分析とレポート作成
- Hadoop 上の ETL プロセス
- インタラクティブなデータ探索
- 企業向けのデータウェアハウス
ユーザーレビュー
3.0
5点中
3.0
まだレビューがありません
このツールの最初のレビュアーになりましょう!