



SQuAD
Stanford Question Answering Dataset (SQuAD) is a new reading comprehension dataset, consisting of questions posed by crowdworkers on a set of Wikipedia articles, where the answer to every question is a segment of text, or span, from the corresponding reading passage. With 100,000+ question-answer pairs on 500+ articles, SQuAD is significantly larger than previous reading comprehension datasets.
Punteggio
30
Valutazione Utente
3.0
Supporto Gratuito/Prova
Supportato
Prezzo Iniziale
--
Ultimo Aggiornamento
mag 02, 2026
Panoramica
Cos'è SQuAD?
Lo Stanford Question Answering Dataset (SQuAD) è un set di dati sulla comprensione della lettura costituito da domande su articoli di Wikipedia, in cui le risposte sono parti di testo tratte da passaggi. SQuAD2.0 aggiunge domande senza risposta per testare la capacità dei sistemi di astenersi quando non esiste alcuna risposta.
A cosa serve SQuAD?
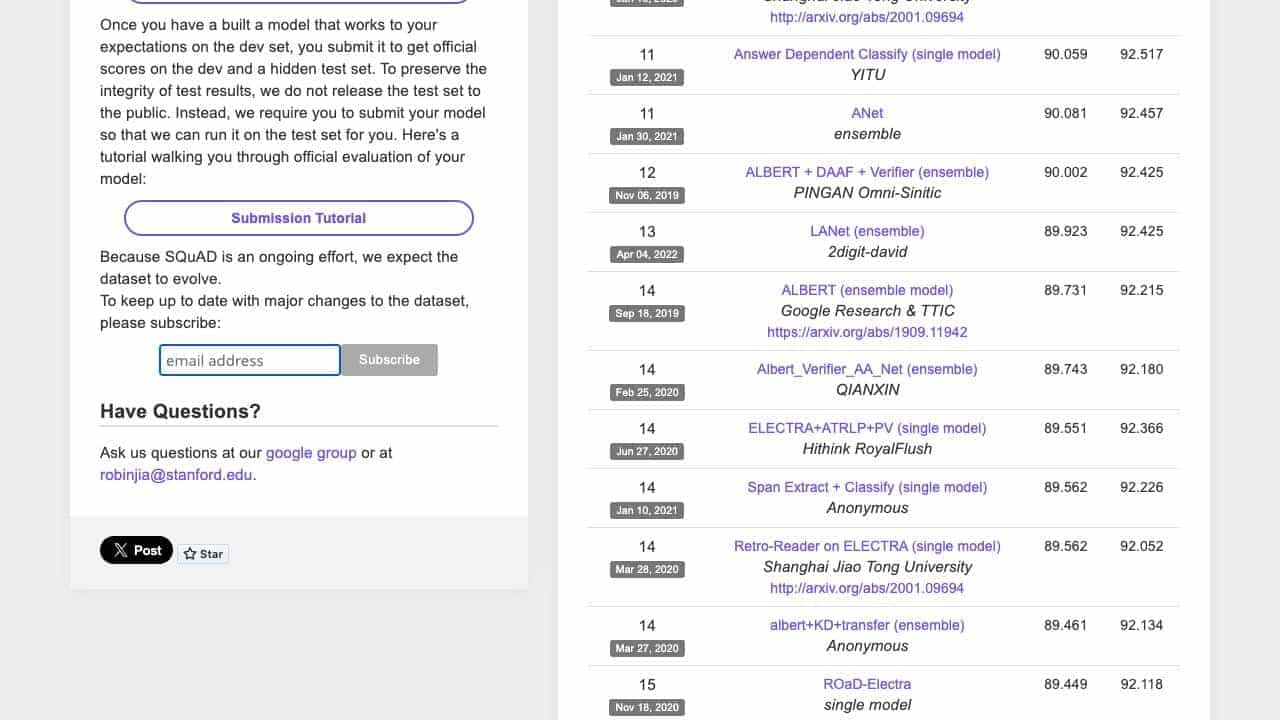
Funzionalità Principali
- Set di dati sulla comprensione della lettura
- Include domande con risposta e senza risposta
- Script di valutazione disponibile
- Classifica per il confronto dei modelli
- Scaricabile gratuitamente con licenza CC BY-SA 4.0
Come usare SQuAD?
Scarica il set di dati, utilizza lo script di valutazione per testare i modelli sui set di sviluppo e invia i modelli per il punteggio ufficiale sui set di test nascosti tramite il tutorial fornito.
Strumenti Alternativi
Nessuno strumento alternativo trovato
Pro & Contro
Pro
- Punto di riferimento di alta qualità per la PNL
- Gratuito e open source
- Supporta la valutazione e l'invio del modello
- Ampiamente utilizzato nella ricerca accademica
Contro
- Limitato al testo inglese
- Richiede competenze tecniche per l'utilizzo
- Nessuno strumento integrato per l'addestramento del modello
Casi d'Uso
- Modelli di intelligenza artificiale per la risposta alle domande
- La ricerca accademica in PNL
- Benchmarking dei sistemi di apprendimento automatico
Prezzi di SQuAD
Piano Gratuito
Nessuna informazione dettagliata sui prezzi disponibile
Recensioni Utenti
3.0
su 5
3.0
Nessuna recensione ancora
Sii il primo a recensire questo strumento!