



CMU Q/A Dataset
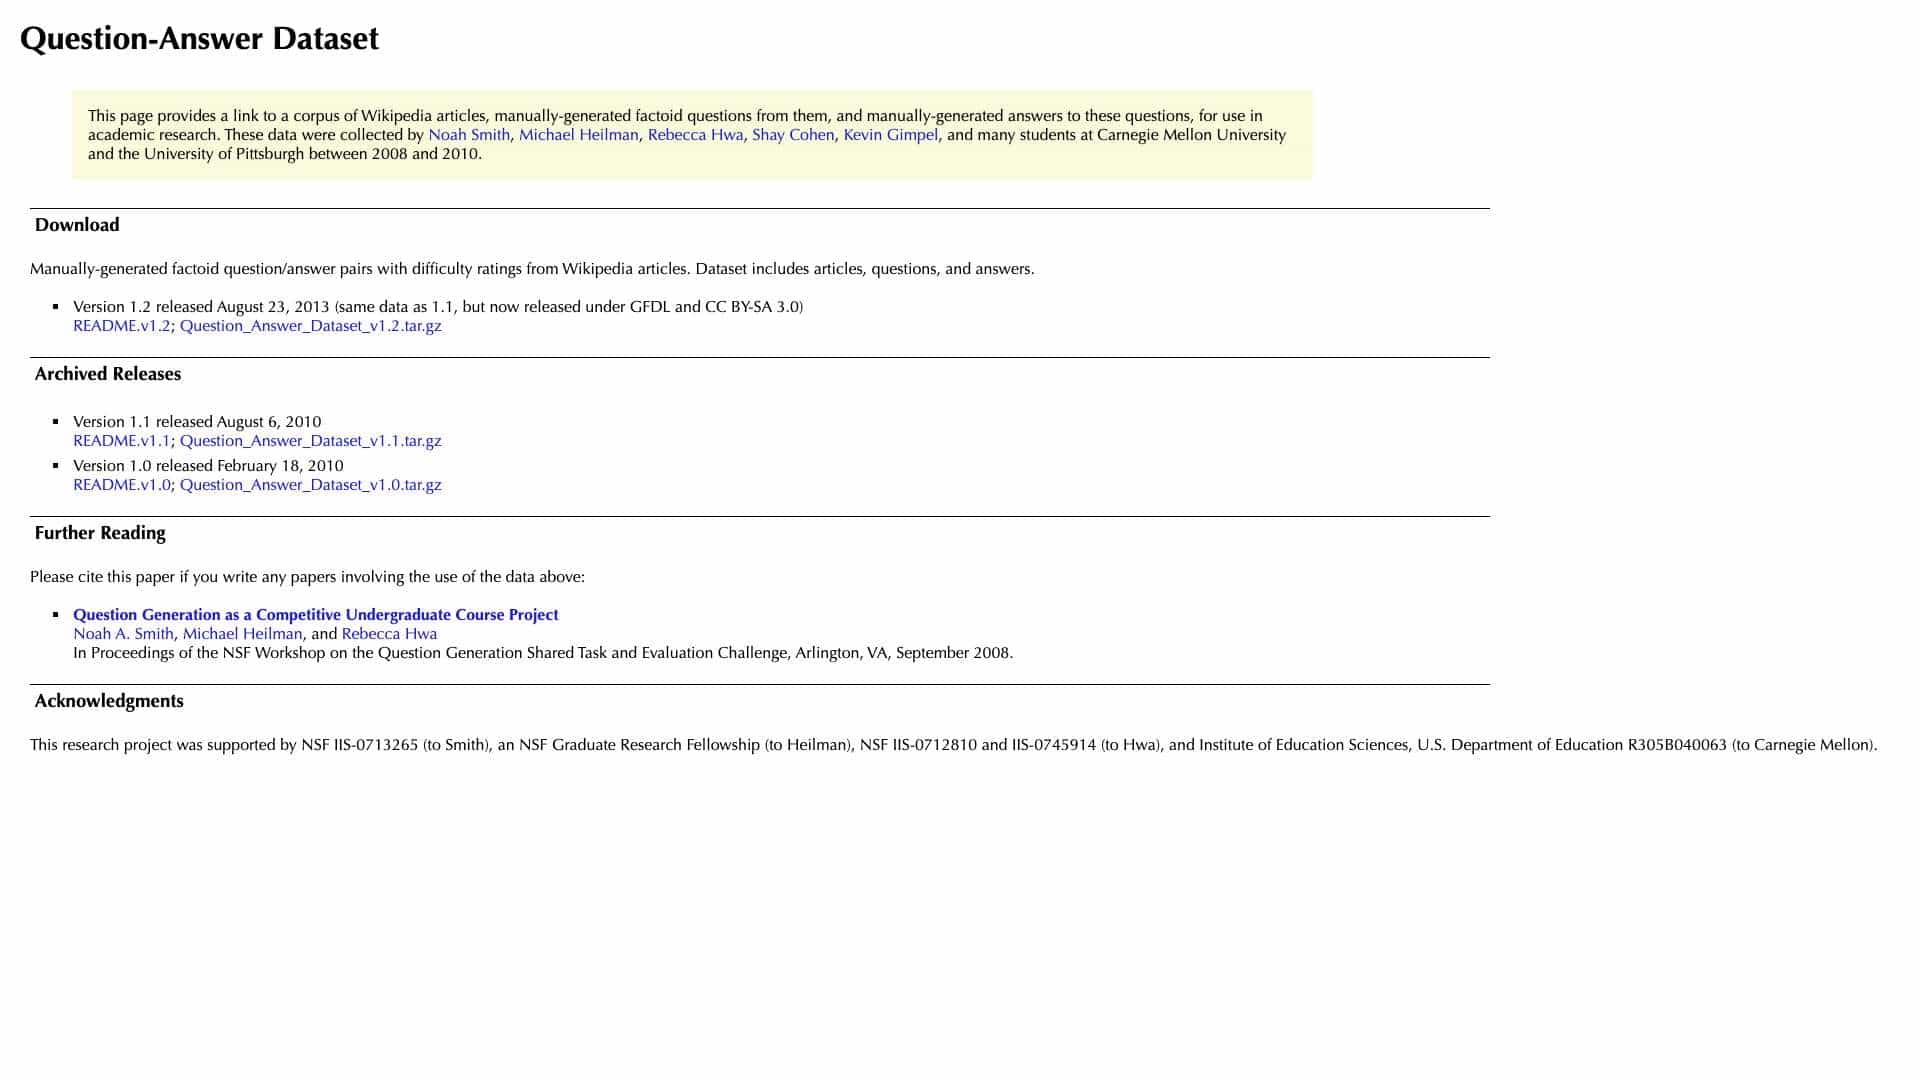
A dataset of Wikipedia articles with manually-generated factoid questions and answers for academic research, collected between 2008-2010.
Punteggio
30
Valutazione Utente
3.0
Supporto Gratuito/Prova
Supportato
Prezzo Iniziale
--
Ultimo Aggiornamento
giu 10, 2026
Panoramica
Cos'è CMU Q/A Dataset?
Si tratta di un corpus di articoli di Wikipedia abbinati a domande e risposte factoid create manualmente, progettate per l'uso nella ricerca accademica sulla generazione e risposta di domande. Include valutazioni di difficoltà e più versioni rilasciate con licenze aperte.
A cosa serve CMU Q/A Dataset?
Funzionalità Principali
- Articoli di Wikipedia
- Domande generate manualmente
- Risposte generate manualmente
- Valutazioni di difficoltà
- Disponibili più versioni
- Licenze aperte (GFDL, CC BY-SA)
Come usare CMU Q/A Dataset?
Scarica i file del set di dati (ad esempio, archivi tar.gz) dai collegamenti forniti, estraili e utilizza gli articoli, le domande e le risposte per progetti di ricerca, come la formazione o la valutazione di modelli di elaborazione del linguaggio naturale.
Strumenti Alternativi
Nessuno strumento alternativo trovato
Pro & Contro
Pro
- Annotazioni manuali di alta qualità
- Utile per la ricerca sulla PNL
- Gratuito da scaricare e utilizzare
- Include citazioni accademiche
Contro
- I dati del periodo 2008-2010 potrebbero essere obsoleti
- Limitato a domande fattuali
- Nessun aggiornamento o supporto attivo
Casi d'Uso
- Ricerca accademica sulla risposta alle domande
- Addestramento di modelli di machine learning
- Progetti formativi nei corsi di PNL
Prezzi di CMU Q/A Dataset
Piano Gratuito
Nessuna informazione dettagliata sui prezzi disponibile
Recensioni Utenti
3.0
su 5
3.0
Nessuna recensione ancora
Sii il primo a recensire questo strumento!