



ApacheTajo
Apache Tajo,SQL-on-Hadoop,big data warehouse system on Hadoop,relational and distributed query engine
Skor
30
Peringkat Pengguna
3.0
Dukungan Gratis/Uji Coba
Tidak Didukung
Harga Mulai
--
Terakhir Diperbarui
Agt 04, 2026
Ringkasan
Apa itu ApacheTajo?
Apache Tajo adalah sistem gudang data relasional dan terdistribusi big data yang dirancang untuk Apache Hadoop. Ini mendukung standar SQL, mengaktifkan kueri ad-hoc latensi rendah, agregasi online, dan ETL pada kumpulan data besar yang disimpan di HDFS dan sumber lain, dengan pengoptimalan kueri tingkat lanjut dan toleransi kesalahan.
Untuk apa ApacheTajo digunakan?
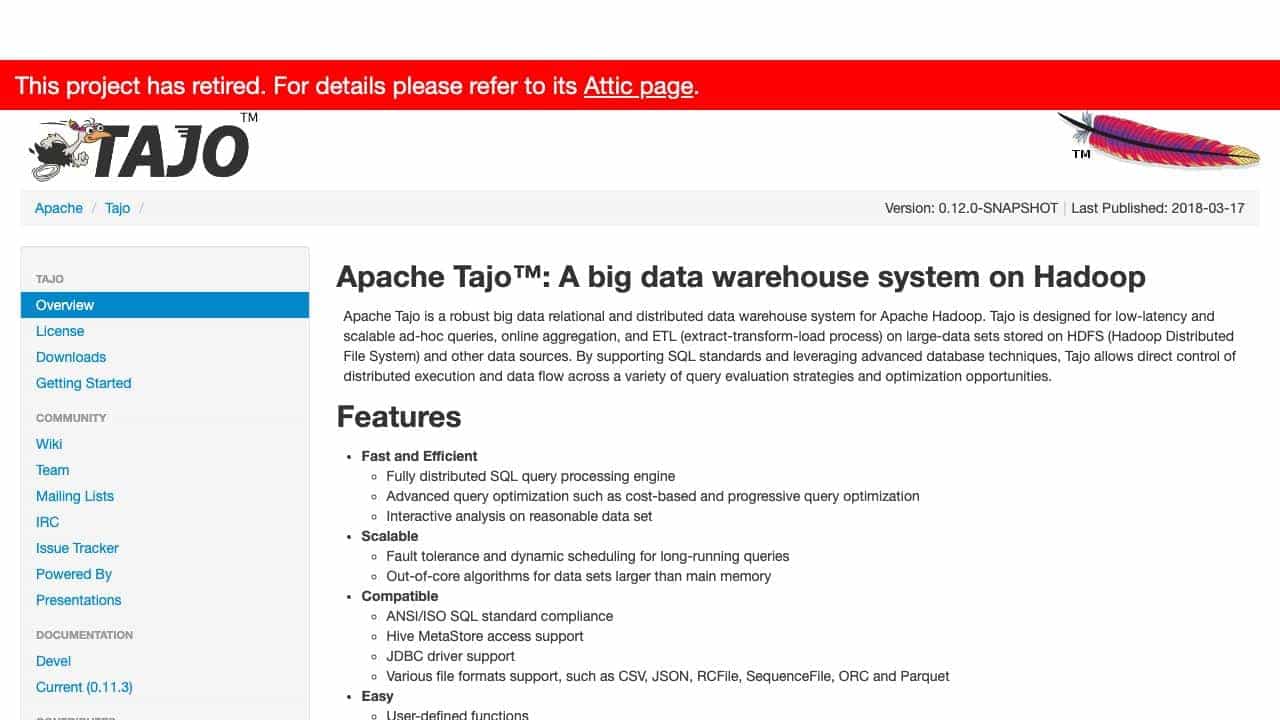
Fitur Unggulan
- Pemrosesan kueri SQL terdistribusi
- Pengoptimalan kueri tingkat lanjut
- Toleransi kesalahan dan penjadwalan dinamis
- Kepatuhan ANSI/ISO SQL
- Dukungan untuk berbagai format file
- Fungsi yang ditentukan pengguna
- Cangkang interaktif
- Dukungan pengemudi JDBC
Bagaimana cara menggunakan ApacheTajo?
Terapkan Tajo di kluster Hadoop, gunakan SQL untuk membuat kueri data, manfaatkan JDBC untuk konektivitas, dan manfaatkan shell interaktif dan API untuk pemrosesan dan analisis data pada kumpulan data besar.
Alat Alternatif
Tidak ada alat alternatif ditemukan
Kelebihan & Kekurangan
Kelebihan
- Dapat diskalakan untuk data besar
- Kueri dengan latensi rendah
- Sumber terbuka dan gratis
- Kompatibel dengan ekosistem Hadoop
- Mendukung berbagai sumber data
Kekurangan
- Proyek pensiun (tidak ada pengembangan aktif)
- Membutuhkan infrastruktur Hadoop
- Kurva pembelajaran yang curam untuk pemula
Kasus Penggunaan
- Analisis dan pelaporan data besar
- Proses ETL di Hadoop
- Eksplorasi data interaktif
- Gudang data untuk perusahaan
Ulasan Pengguna
3.0
dari 5
3.0
Belum ada ulasan
Jadilah yang pertama mengulas alat ini!