



Stanford Sentiment Treebank
This website provides a live demo for predicting the sentiment of movie reviews. Most sentiment prediction systems work just by looking at words in isolation, giving positive points for positive words and negative points for negative words and then summing up these points. That way, the order of words is ignored and important information is lost. In constrast, our new deep learning model actually builds up a representation of whole sentences based on the sentence structure. It computes the sentiment based on how words compose the meaning of longer phrases.
स्कोर
30
उपयोगकर्ता रेटिंग
3.0
मुफ्त/ट्रायल सहायता
समर्थित नहीं
प्रारंभिक मूल्य
--
अंतिम अपडेट
अग 04, 2026
अवलोकन
Stanford Sentiment Treebank क्या है?
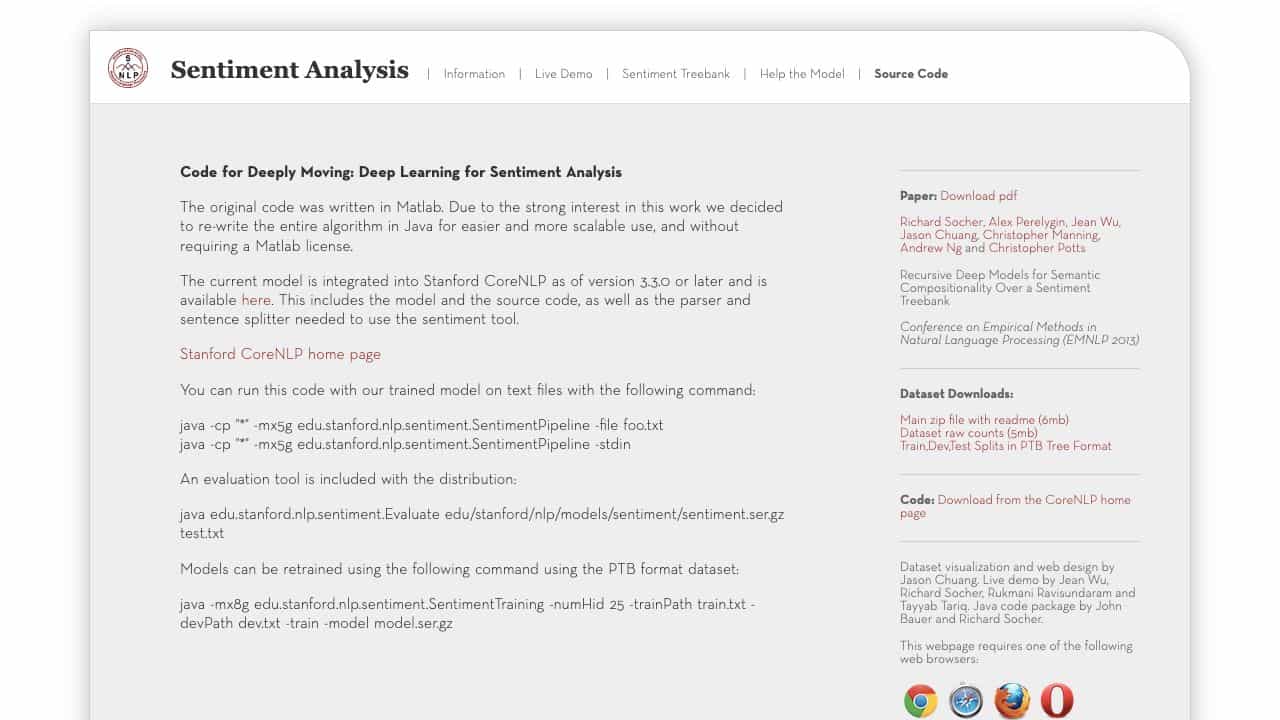
स्टैनफोर्ड सेंटीमेंट ट्रीबैंक भावना विश्लेषण के लिए एक डेटासेट और उपकरण है, जिसमें एक गहन शिक्षण मॉडल है जो वाक्यांश और वाक्य स्तर पर भावना का विश्लेषण करता है। इसमें जावा (मूल रूप से मैटलैब) में कोड शामिल है और यह स्टैनफोर्ड कोरएनएलपी का हिस्सा है।
Stanford Sentiment Treebank किस लिए उपयोग किया जाता है?
शीर्ष सुविधाएं
- भावना विश्लेषण के लिए गहन शिक्षण मॉडल
- स्टैनफोर्ड कोरएनएलपी के साथ एकीकरण
- स्केलेबिलिटी के लिए जावा कोड
- ट्रेन/डेवलपमेंट/परीक्षण विभाजन के साथ डेटासेट
- लाइव डेमो उपलब्ध है
Stanford Sentiment Treebank का उपयोग कैसे करें?
कमांड लाइन के माध्यम से टेक्स्ट फ़ाइलों पर भावना विश्लेषण चलाने, कस्टम डेटासेट के साथ मॉडल को फिर से प्रशिक्षित करने या ऑनलाइन लाइव डेमो तक पहुंचने के लिए कोरएनएलपी के साथ दिए गए जावा कोड का उपयोग करें।
वैकल्पिक टूल
कोई वैकल्पिक टूल नहीं मिला
फायदे & नुकसान
फायदे
- मुफ़्त और खुला स्रोत
- पुनर्प्रशिक्षण के लिए उच्च अनुकूलनशीलता
- स्व-होस्टेड परिनियोजन का समर्थन करता है
- शोध पत्र के साथ अच्छी तरह से प्रलेखित
नुकसान
- जावा और तकनीकी सेटअप की आवश्यकता है
- कोई अंतर्निहित GUI नहीं, केवल कमांड-लाइन
उपयोग के मामले
- एनएलपी में अकादमिक अनुसंधान
- अनुप्रयोगों में भावना विश्लेषण
- कस्टम भावना मॉडल का प्रशिक्षण
उपयोगकर्ता समीक्षाएं
3.0
5 में से
3.0
अभी तक कोई समीक्षा नहीं
इस टूल की पहली समीक्षा करने वाले बनें!