



SQuAD
Stanford Question Answering Dataset (SQuAD) is a new reading comprehension dataset, consisting of questions posed by crowdworkers on a set of Wikipedia articles, where the answer to every question is a segment of text, or span, from the corresponding reading passage. With 100,000+ question-answer pairs on 500+ articles, SQuAD is significantly larger than previous reading comprehension datasets.
स्कोर
30
उपयोगकर्ता रेटिंग
3.0
मुफ्त/ट्रायल सहायता
समर्थित
प्रारंभिक मूल्य
--
अंतिम अपडेट
मई 02, 2026
अवलोकन
SQuAD क्या है?
स्टैनफोर्ड क्वेश्चन आंसरिंग डेटासेट (एसक्यूएडी) एक रीडिंग कॉम्प्रिहेंशन डेटासेट है जिसमें विकिपीडिया लेखों पर प्रश्न शामिल हैं, जहां उत्तर अनुच्छेदों के पाठ विस्तार हैं। SQuAD2.0 कोई उत्तर मौजूद न होने पर सिस्टम की टालने की क्षमता का परीक्षण करने के लिए अनुत्तरित प्रश्न जोड़ता है।
SQuAD किस लिए उपयोग किया जाता है?
शीर्ष सुविधाएं
- पढ़ने की समझ का डेटासेट
- उत्तर देने योग्य और अनुत्तरित प्रश्न शामिल हैं
- मूल्यांकन स्क्रिप्ट उपलब्ध है
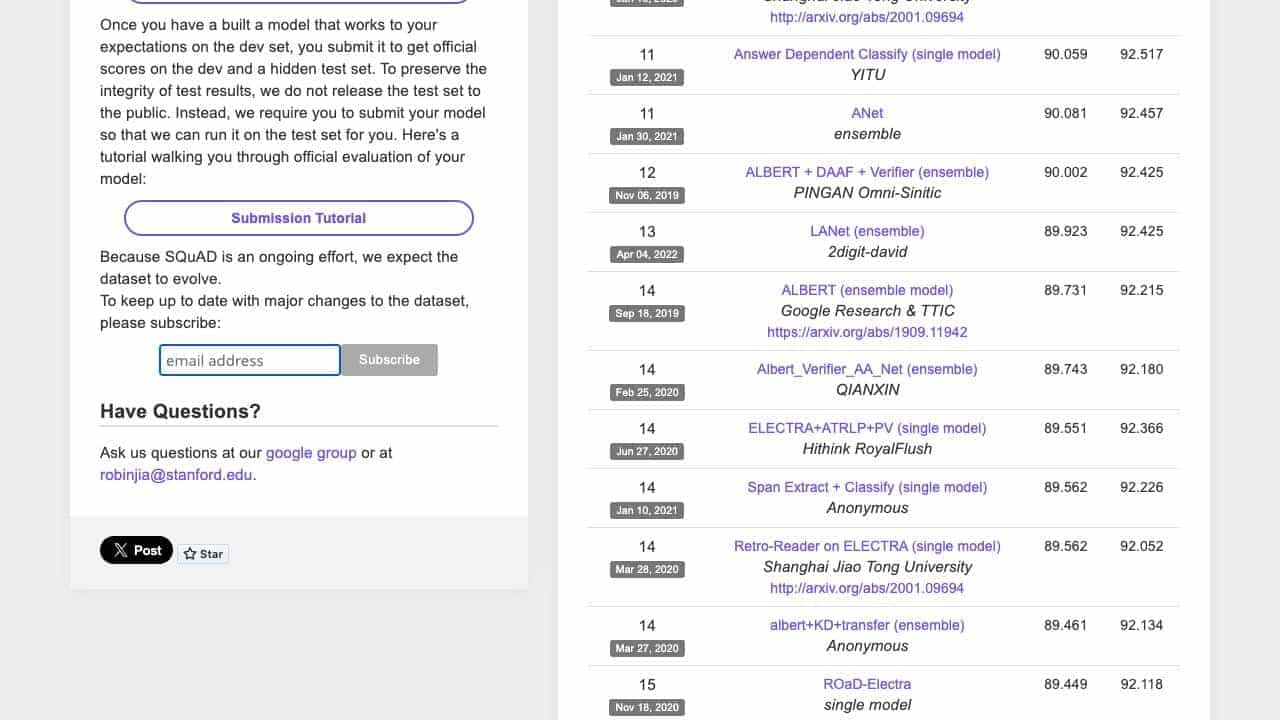
- मॉडल तुलना के लिए लीडरबोर्ड
- CC BY-SA 4.0 लाइसेंस के तहत डाउनलोड करने के लिए निःशुल्क
SQuAD का उपयोग कैसे करें?
डेटासेट डाउनलोड करें, डेव सेट पर मॉडल का परीक्षण करने के लिए मूल्यांकन स्क्रिप्ट का उपयोग करें, और दिए गए ट्यूटोरियल के माध्यम से छिपे हुए परीक्षण सेट पर आधिकारिक स्कोरिंग के लिए मॉडल सबमिट करें।
वैकल्पिक टूल
कोई वैकल्पिक टूल नहीं मिला
फायदे & नुकसान
फायदे
- एनएलपी के लिए उच्च गुणवत्ता वाले बेंचमार्क
- मुफ़्त और खुला स्रोत
- मॉडल मूल्यांकन और प्रस्तुतीकरण का समर्थन करता है
- अकादमिक अनुसंधान में व्यापक रूप से उपयोग किया जाता है
नुकसान
- अंग्रेजी पाठ तक सीमित
- उपयोग के लिए तकनीकी विशेषज्ञता की आवश्यकता है
- मॉडल प्रशिक्षण के लिए कोई अंतर्निहित उपकरण नहीं
उपयोग के मामले
- प्रश्न उत्तर के लिए एआई मॉडल का प्रशिक्षण
- एनएलपी में अकादमिक अनुसंधान
- बेंचमार्किंग मशीन लर्निंग सिस्टम
SQuAD मूल्य
मुफ्त योजना
कोई विस्तृत मूल्य जानकारी उपलब्ध नहीं
उपयोगकर्ता समीक्षाएं
3.0
5 में से
3.0
अभी तक कोई समीक्षा नहीं
इस टूल की पहली समीक्षा करने वाले बनें!