



CMU Q/A Dataset
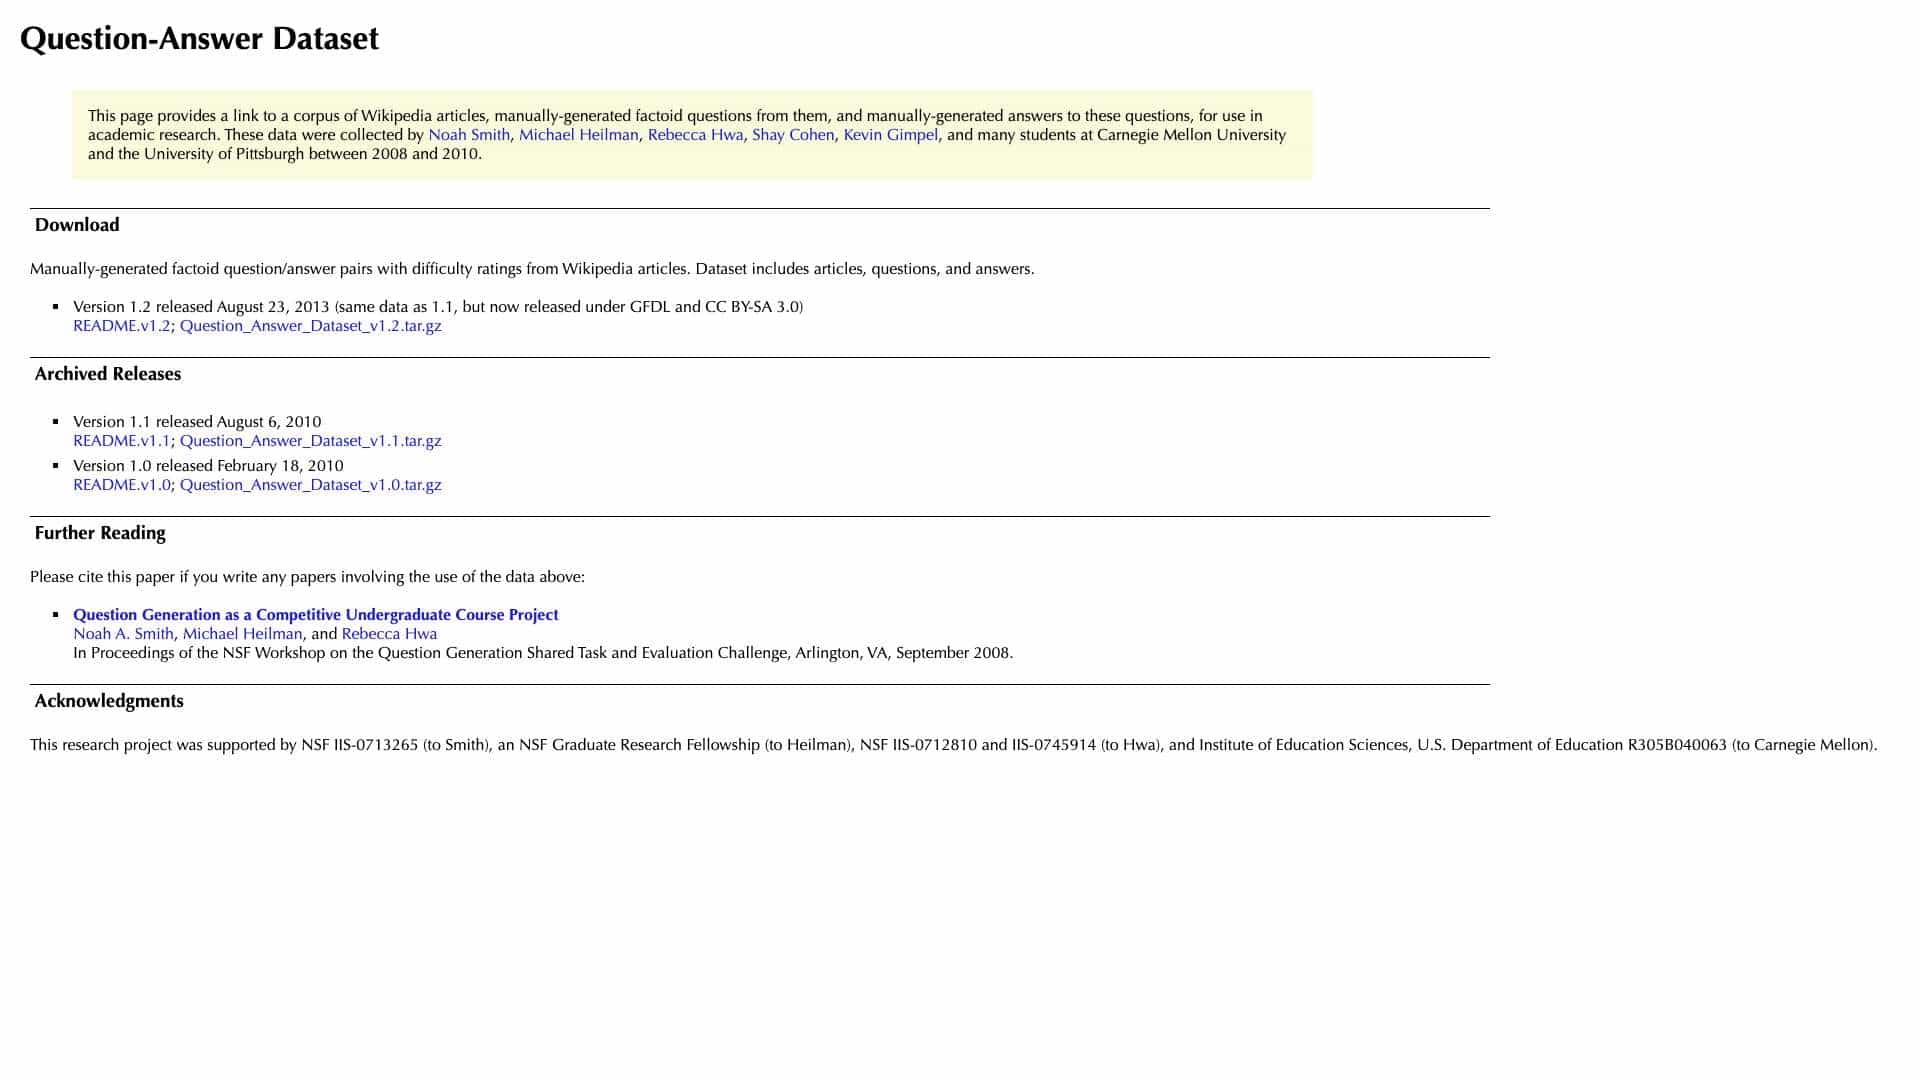
A dataset of Wikipedia articles with manually-generated factoid questions and answers for academic research, collected between 2008-2010.
स्कोर
30
उपयोगकर्ता रेटिंग
3.0
मुफ्त/ट्रायल सहायता
समर्थित
प्रारंभिक मूल्य
--
अंतिम अपडेट
जून 10, 2026
अवलोकन
CMU Q/A Dataset क्या है?
यह विकिपीडिया लेखों का एक संग्रह है जो मैन्युअल रूप से बनाए गए तथ्यात्मक प्रश्नों और उत्तरों के साथ जोड़ा गया है, जिसे प्रश्न निर्माण और उत्तर देने पर अकादमिक शोध में उपयोग के लिए डिज़ाइन किया गया है। इसमें कठिनाई रेटिंग और खुले लाइसेंस के तहत जारी किए गए कई संस्करण शामिल हैं।
CMU Q/A Dataset किस लिए उपयोग किया जाता है?
शीर्ष सुविधाएं
- विकिपीडिया लेख
- मैन्युअल रूप से उत्पन्न प्रश्न
- मैन्युअल रूप से तैयार किए गए उत्तर
- कठिनाई रेटिंग
- एकाधिक संस्करण उपलब्ध हैं
- ओपन लाइसेंस (GFDL, CC BY-SA)
CMU Q/A Dataset का उपयोग कैसे करें?
दिए गए लिंक से डेटासेट फ़ाइलें (उदाहरण के लिए, tar.gz अभिलेखागार) डाउनलोड करें, उन्हें निकालें, और प्राकृतिक भाषा प्रसंस्करण मॉडल का प्रशिक्षण या मूल्यांकन जैसे अनुसंधान परियोजनाओं के लिए लेख, प्रश्न और उत्तर का उपयोग करें।
वैकल्पिक टूल
कोई वैकल्पिक टूल नहीं मिला
फायदे & नुकसान
फायदे
- उच्च गुणवत्ता वाले मैनुअल एनोटेशन
- एनएलपी अनुसंधान के लिए उपयोगी
- डाउनलोड मुफ्त में और प्रयोग करें
- अकादमिक उद्धरण शामिल हैं
नुकसान
- 2008-2010 का डेटा पुराना हो सकता है
- तथ्यात्मक प्रश्नों तक सीमित
- कोई सक्रिय अद्यतन या समर्थन नहीं
उपयोग के मामले
- प्रश्न उत्तर पर अकादमिक शोध
- प्रशिक्षण मशीन लर्निंग मॉडल
- एनएलपी पाठ्यक्रमों में शैक्षिक परियोजनाएं
CMU Q/A Dataset मूल्य
मुफ्त योजना
कोई विस्तृत मूल्य जानकारी उपलब्ध नहीं
उपयोगकर्ता समीक्षाएं
3.0
5 में से
3.0
अभी तक कोई समीक्षा नहीं
इस टूल की पहली समीक्षा करने वाले बनें!