



ApacheTajo
Apache Tajo,SQL-on-Hadoop,big data warehouse system on Hadoop,relational and distributed query engine
स्कोर
30
उपयोगकर्ता रेटिंग
3.0
मुफ्त/ट्रायल सहायता
समर्थित नहीं
प्रारंभिक मूल्य
--
अंतिम अपडेट
अग 04, 2026
अवलोकन
ApacheTajo क्या है?
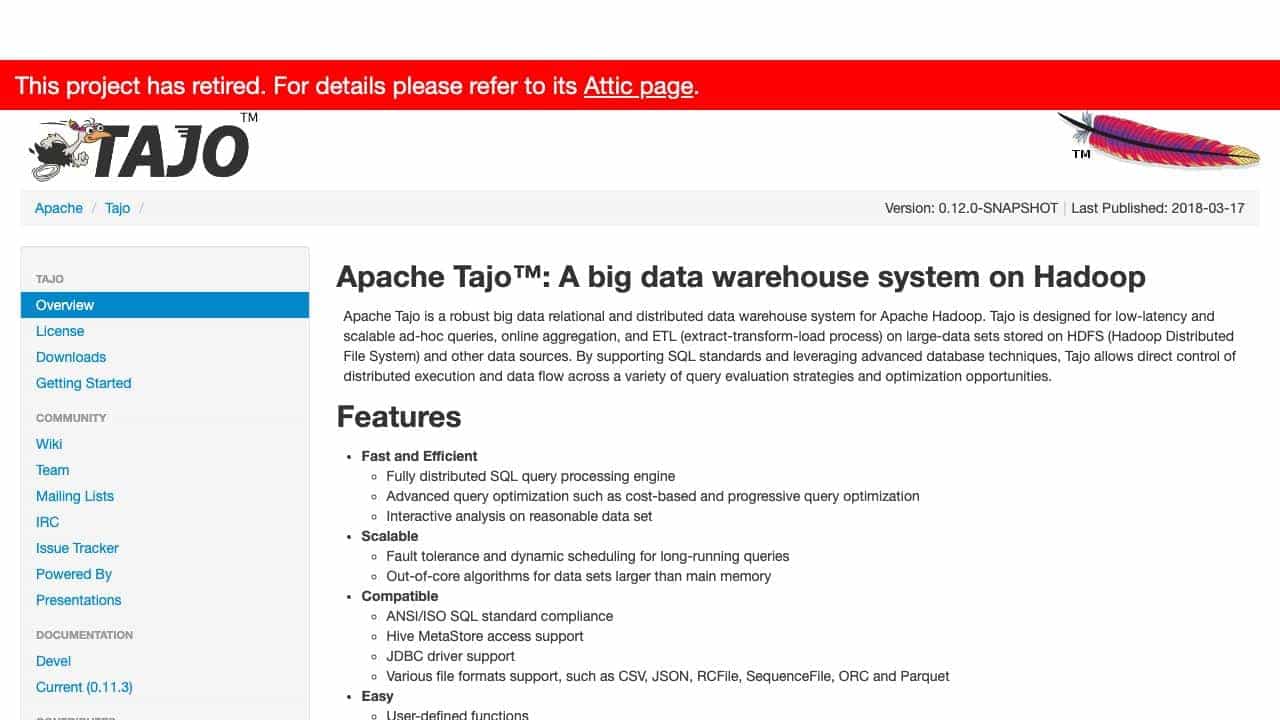
अपाचे ताजो अपाचे Hadoop के लिए डिज़ाइन किया गया एक मजबूत बड़ा डेटा रिलेशनल और वितरित डेटा वेयरहाउस सिस्टम है। यह SQL मानकों का समर्थन करता है, उन्नत क्वेरी अनुकूलन और दोष सहनशीलता के साथ HDFS और अन्य स्रोतों पर संग्रहीत बड़े डेटासेट पर कम-विलंबता तदर्थ क्वेरी, ऑनलाइन एकत्रीकरण और ETL को सक्षम करता है।
ApacheTajo किस लिए उपयोग किया जाता है?
शीर्ष सुविधाएं
- वितरित SQL क्वेरी प्रोसेसिंग
- उन्नत क्वेरी अनुकूलन
- दोष सहनशीलता और गतिशील शेड्यूलिंग
- एएनएसआई/आईएसओ एसक्यूएल अनुपालन
- विभिन्न फ़ाइल स्वरूपों के लिए समर्थन
- उपयोगकर्ता-परिभाषित फ़ंक्शन
- इंटरएक्टिव शेल
- जेडीबीसी ड्राइवर समर्थन
ApacheTajo का उपयोग कैसे करें?
Hadoop क्लस्टर पर ताजो को तैनात करें, डेटा को क्वेरी करने के लिए SQL का उपयोग करें, कनेक्टिविटी के लिए JDBC का लाभ उठाएं, और बड़े डेटा सेट पर डेटा प्रोसेसिंग और विश्लेषण के लिए इसके इंटरैक्टिव शेल और API का उपयोग करें।
वैकल्पिक टूल
कोई वैकल्पिक टूल नहीं मिला
फायदे & नुकसान
फायदे
- बड़े डेटा के लिए स्केलेबल
- कम विलंबता वाले प्रश्न
- ओपन-सोर्स और मुफ़्त
- Hadoop पारिस्थितिकी तंत्र के साथ संगत
- एकाधिक डेटा स्रोतों का समर्थन करता है
नुकसान
- सेवानिवृत्त परियोजना (कोई सक्रिय विकास नहीं)
- Hadoop बुनियादी ढांचे की आवश्यकता है
- शुरुआती लोगों के लिए तीव्र सीखने की अवस्था
उपयोग के मामले
- बिग डेटा एनालिटिक्स और रिपोर्टिंग
- Hadoop पर ETL प्रक्रियाएँ
- इंटरएक्टिव डेटा अन्वेषण
- उद्यमों के लिए डेटा भंडारण
उपयोगकर्ता समीक्षाएं
3.0
5 में से
3.0
अभी तक कोई समीक्षा नहीं
इस टूल की पहली समीक्षा करने वाले बनें!