



Spark SQL
Module d'Apache Spark pour interroger des données structurées à l'aide de l'API SQL ou DataFrame, intégré aux programmes Spark et prenant en charge plusieurs sources de données.
Score
30
Évaluation Utilisateur
3.0
Support Gratuit/Essai
Non Pris en Charge
Prix de Démarrage
--
Dernière Mise à Jour
août 04, 2026
Aperçu
Qu'est-ce que Spark SQL ?
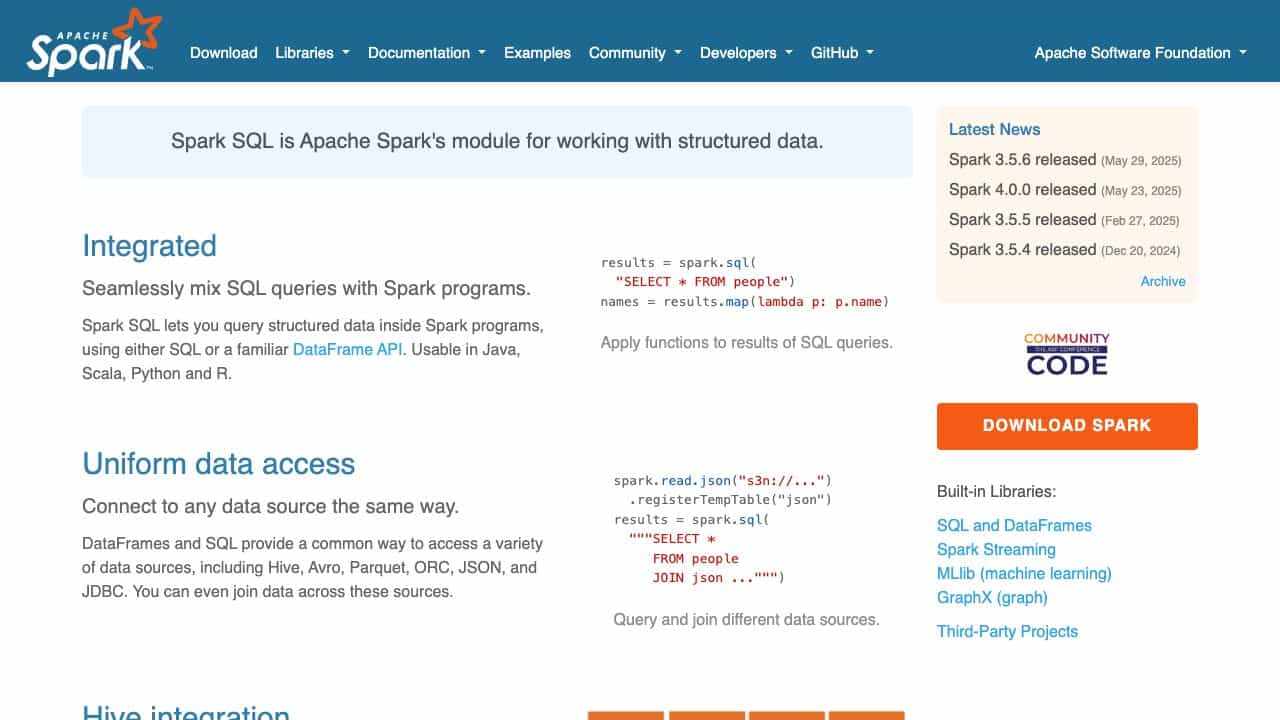
Spark SQL est un module d'Apache Spark conçu pour traiter des données structurées. Il permet aux utilisateurs d'exécuter des requêtes SQL de manière transparente dans les applications Spark, en utilisant soit la syntaxe SQL, soit une API DataFrame. Il prend en charge l'intégration avec diverses sources de données telles que Hive, JSON, Parquet et JDBC/ODBC, et inclut des fonctionnalités de performances telles que l'optimisation basée sur les coûts et le stockage en colonnes.
À quoi sert Spark SQL ?
Fonctionnalités Principales
- Requêtes SQL intégrées avec les programmes Spark
- Accès uniforme aux données sur plusieurs sources
- Intégration Hive pour les entrepôts existants
- Connectivité JDBC/ODBC pour les outils BI
- Optimisation des performances avec un optimiseur basé sur les coûts et un stockage en colonnes
Comment utiliser Spark SQL ?
Téléchargez Apache Spark, qui inclut Spark SQL. Utilisez le guide Spark SQL ou DataFrame pour découvrir l'API. Écrivez des requêtes en SQL ou utilisez l'API DataFrame en Java, Scala, Python ou R pour accéder et joindre des données provenant de plusieurs sources comme Hive, JSON ou JDBC.
Outils Alternatifs
Aucun outil alternatif trouvé
Avantages & Inconvénients
Avantages
- Intégration transparente avec Spark
- Prend en charge plusieurs langages de programmation
- Haute évolutivité et tolérance aux pannes
- Gratuit et open source sous licence Apache
Inconvénients
- Nécessite l'apprentissage de l'écosystème Spark
- Peut avoir une courbe d'apprentissage abrupte pour les débutants
Cas d'Utilisation
- Analyse et requêtes Big Data
- Intégration de données provenant de diverses sources
- Rapports de veille économique
- Prétraitement des données d'apprentissage automatique
Avis Utilisateurs
3.0
sur 5
3.0
Aucun avis pour le moment
Soyez le premier à évaluer cet outil !