



CMU Q/A Dataset
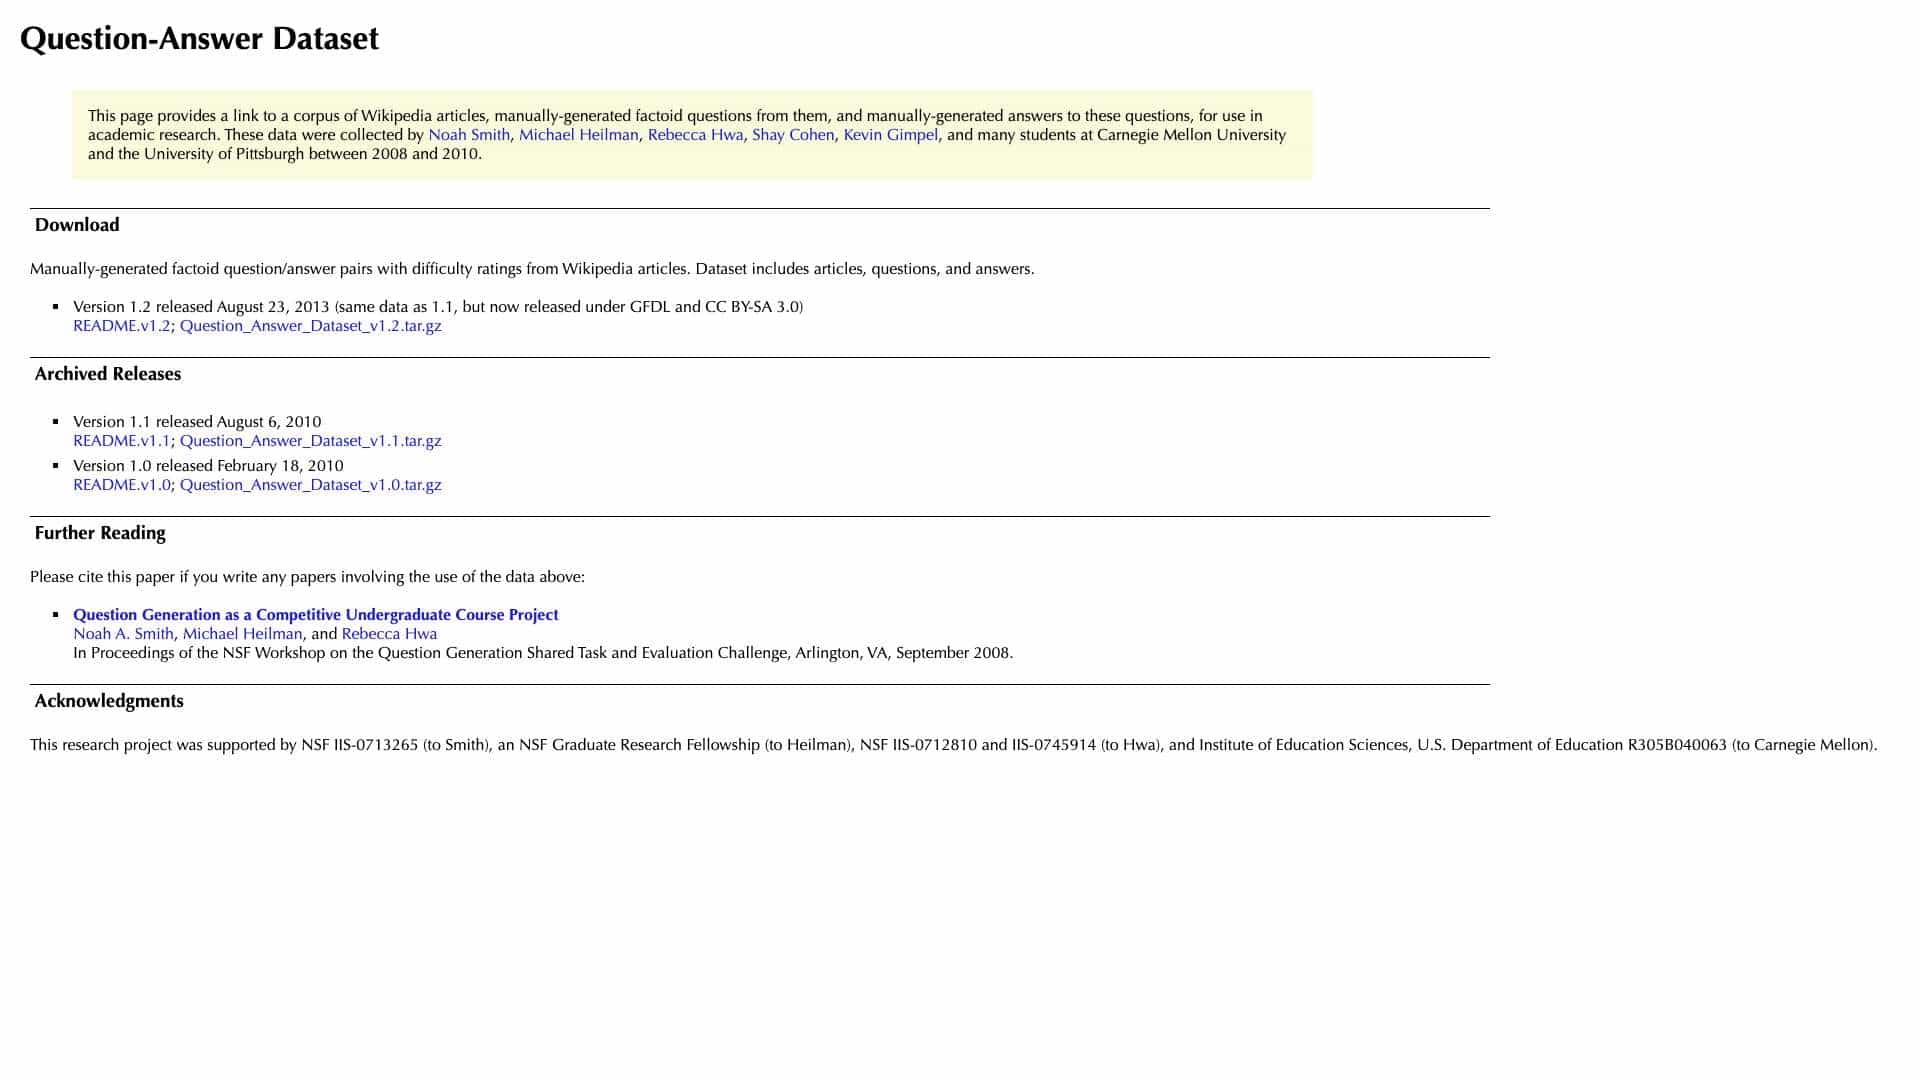
Un ensemble de données d'articles Wikipédia avec des questions et réponses factuelles générées manuellement pour la recherche universitaire, collectées entre 2008 et 2010.
Score
30
Évaluation Utilisateur
3.0
Support Gratuit/Essai
Pris en Charge
Prix de Démarrage
--
Dernière Mise à Jour
mai 02, 2026
Aperçu
Qu'est-ce que CMU Q/A Dataset ?
Il s'agit d'un corpus d'articles Wikipédia associés à des questions et réponses factuelles créées manuellement, conçues pour être utilisées dans la recherche universitaire sur la génération de questions et leurs réponses. Il comprend des évaluations de difficulté et plusieurs versions publiées sous licences ouvertes.
À quoi sert CMU Q/A Dataset ?
Fonctionnalités Principales
- Articles Wikipédia
- Questions générées manuellement
- Réponses générées manuellement
- Cotes de difficulté
- Plusieurs versions disponibles
- Licences ouvertes (GFDL, CC BY-SA)
Comment utiliser CMU Q/A Dataset ?
Téléchargez les fichiers de l'ensemble de données (par exemple, les archives tar.gz) à partir des liens fournis, extrayez-les et utilisez les articles, questions et réponses pour des projets de recherche, tels que la formation ou l'évaluation de modèles de traitement du langage naturel.
Outils Alternatifs
Aucun outil alternatif trouvé
Avantages & Inconvénients
Avantages
- Annotations manuelles de haute qualité
- Utile pour la recherche en PNL
- Téléchargement et utilisation gratuits
- Comprend des citations académiques
Inconvénients
- Les données de 2008 à 2010 peuvent être obsolètes
- Limité aux questions factuelles
- Aucune mise à jour ou support actif
Cas d'Utilisation
- Recherche universitaire sur la réponse aux questions
- Former des modèles d’apprentissage automatique
- Projets pédagogiques dans les cours de PNL
Tarifs de CMU Q/A Dataset
Plan Gratuit
Aucune information détaillée sur les prix disponible
Avis Utilisateurs
3.0
sur 5
3.0
Aucun avis pour le moment
Soyez le premier à évaluer cet outil !