



ApacheTajo
Apache Tajo est un système d'entrepôt de Big Data distribué sur Hadoop pour les requêtes SQL à faible latence, l'ETL et le traitement de données évolutif.
Score
30
Évaluation Utilisateur
3.0
Support Gratuit/Essai
Non Pris en Charge
Prix de Démarrage
--
Dernière Mise à Jour
août 04, 2026
Aperçu
Qu'est-ce que ApacheTajo ?
Apache Tajo est un système d'entrepôt de données relationnel et distribué robuste conçu pour Apache Hadoop. Il prend en charge les normes SQL, permet des requêtes ad hoc à faible latence, l'agrégation en ligne et l'ETL sur de grands ensembles de données stockés sur HDFS et d'autres sources, avec une optimisation avancée des requêtes et une tolérance aux pannes.
À quoi sert ApacheTajo ?
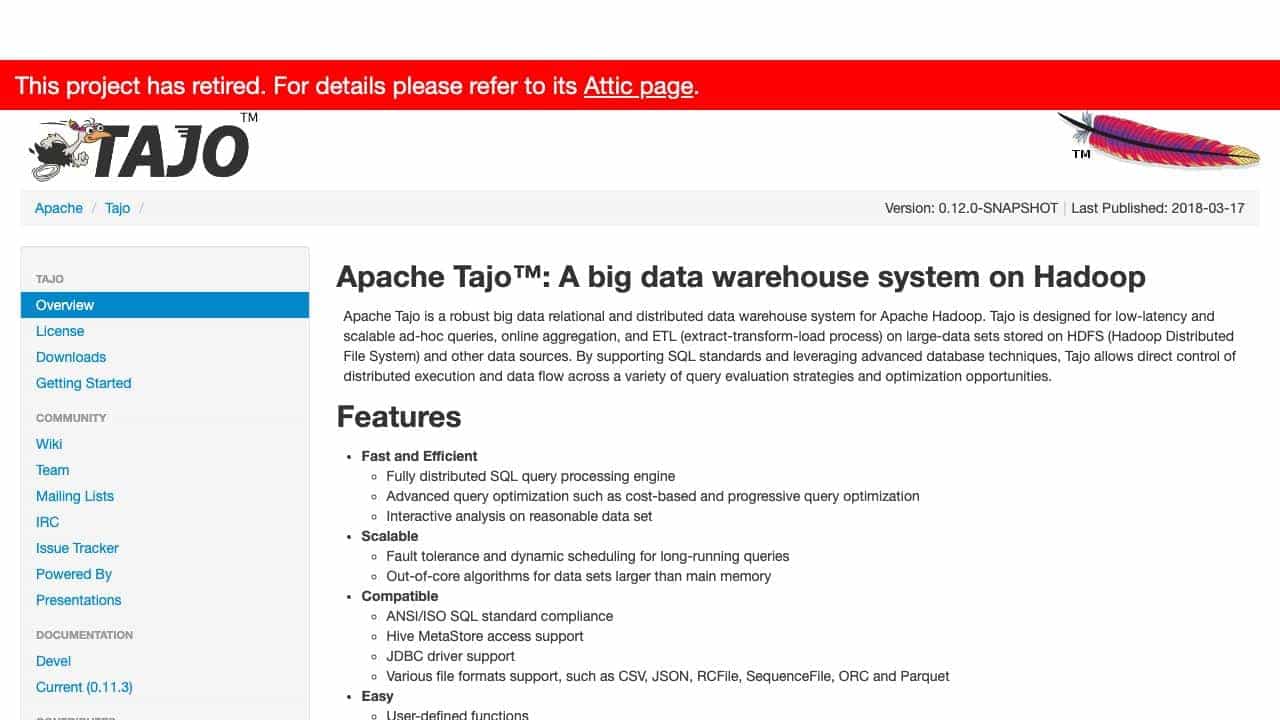
Fonctionnalités Principales
- Traitement des requêtes SQL distribuées
- Optimisation avancée des requêtes
- Tolérance aux pannes et planification dynamique
- Conformité ANSI/ISO SQL
- Prise en charge de différents formats de fichiers
- Fonctions définies par l'utilisateur
- Coque interactive
- Prise en charge du pilote JDBC
Comment utiliser ApacheTajo ?
Déployez Tajo sur des clusters Hadoop, utilisez SQL pour interroger des données, exploitez JDBC pour la connectivité et utilisez son shell interactif et ses API pour le traitement et l'analyse des données sur de grands ensembles de données.
Outils Alternatifs
Aucun outil alternatif trouvé
Avantages & Inconvénients
Avantages
- Évolutif pour le Big Data
- Requêtes à faible latence
- Open source et gratuit
- Compatible avec l'écosystème Hadoop
- Prend en charge plusieurs sources de données
Inconvénients
- Projet retiré (pas de développement actif)
- Nécessite une infrastructure Hadoop
- Courbe d'apprentissage abrupte pour les débutants
Cas d'Utilisation
- Analyse et reporting Big Data
- Processus ETL sur Hadoop
- Exploration interactive des données
- Entreposage de données pour les entreprises
Avis Utilisateurs
3.0
sur 5
3.0
Aucun avis pour le moment
Soyez le premier à évaluer cet outil !