



Spark SQL
Módulo de Apache Spark para consultar datos estructurados usando SQL o API DataFrame, integrado con programas Spark y compatible con múltiples fuentes de datos.
Puntuación
30
Calificación de Usuario
3.0
Soporte Gratuito/Prueba
No Soportado
Precio Inicial
--
Última Actualización
ago 04, 2026
Resumen
¿Qué es Spark SQL?
Spark SQL es un módulo de Apache Spark diseñado para procesar datos estructurados. Permite a los usuarios ejecutar consultas SQL sin problemas dentro de las aplicaciones Spark, utilizando la sintaxis SQL o una API DataFrame. Admite la integración con varias fuentes de datos como Hive, JSON, Parquet y JDBC/ODBC, e incluye funciones de rendimiento como optimización basada en costos y almacenamiento en columnas.
¿Para qué se usa Spark SQL?
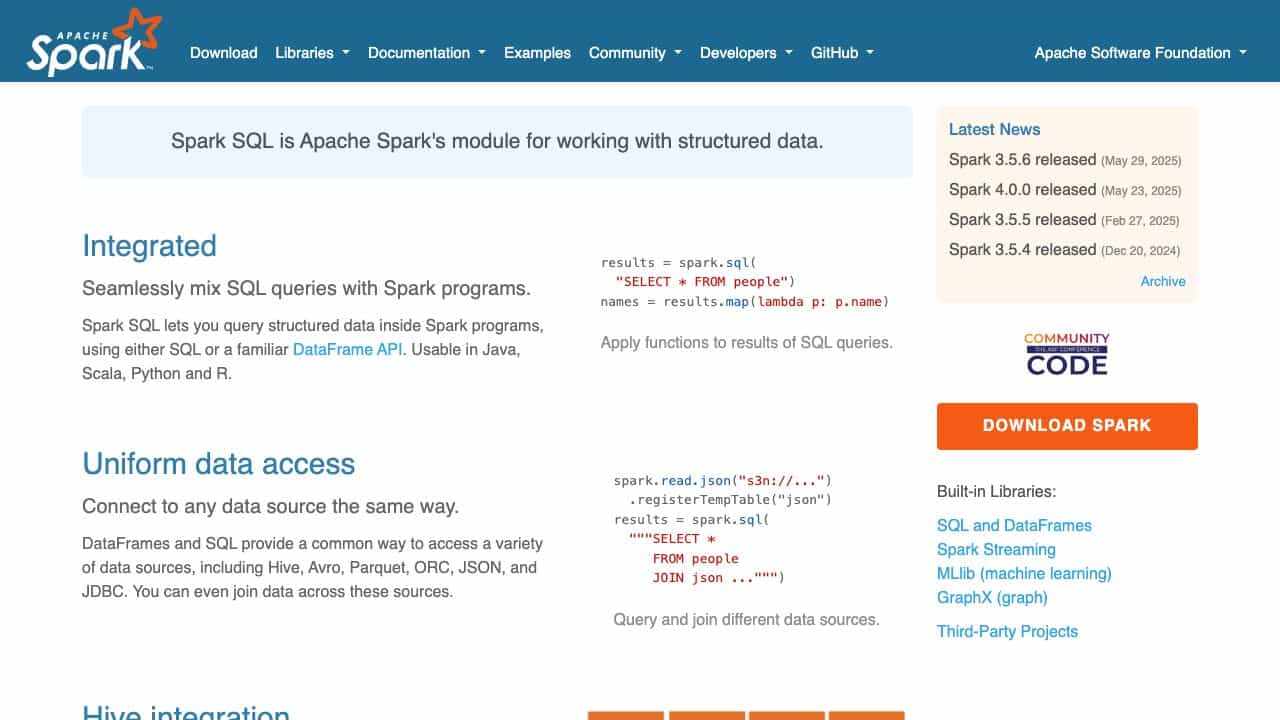
Características Principales
- Consultas SQL integradas con programas Spark.
- Acceso uniforme a datos a través de múltiples fuentes
- Integración de Hive para almacenes existentes
- Conectividad JDBC/ODBC para herramientas de BI
- Optimización del rendimiento con optimizador basado en costos y almacenamiento en columnas
¿Cómo usar Spark SQL?
Descargue Apache Spark, que incluye Spark SQL. Utilice la guía Spark SQL o DataFrame para conocer la API. Escriba consultas en SQL o utilice la API DataFrame en Java, Scala, Python o R para acceder y unir datos de múltiples fuentes como Hive, JSON o JDBC.
Herramientas Alternativas
No se encontraron herramientas alternativas
Pros & Contras
Pros
- Integración perfecta con Spark
- Admite múltiples lenguajes de programación
- Alta escalabilidad y tolerancia a fallos
- Gratis y de código abierto bajo licencia Apache
Contras
- Requiere aprender el ecosistema Spark
- Puede tener una curva de aprendizaje pronunciada para principiantes
Casos de Uso
- Análisis y consultas de big data
- Integración de datos de diversas fuentes.
- Informes de inteligencia empresarial
- Preprocesamiento de datos de aprendizaje automático
Reseñas de Usuarios
3.0
de 5
3.0
Aún no hay reseñas
¡Sé el primero en reseñar esta herramienta!