



CMU Q/A Dataset
Un conjunto de datos de artículos de Wikipedia con preguntas y respuestas factoides generadas manualmente para investigaciones académicas, recopiladas entre 2008 y 2010.
Puntuación
30
Calificación de Usuario
3.0
Soporte Gratuito/Prueba
Soportado
Precio Inicial
--
Última Actualización
may 02, 2026
Resumen
¿Qué es CMU Q/A Dataset?
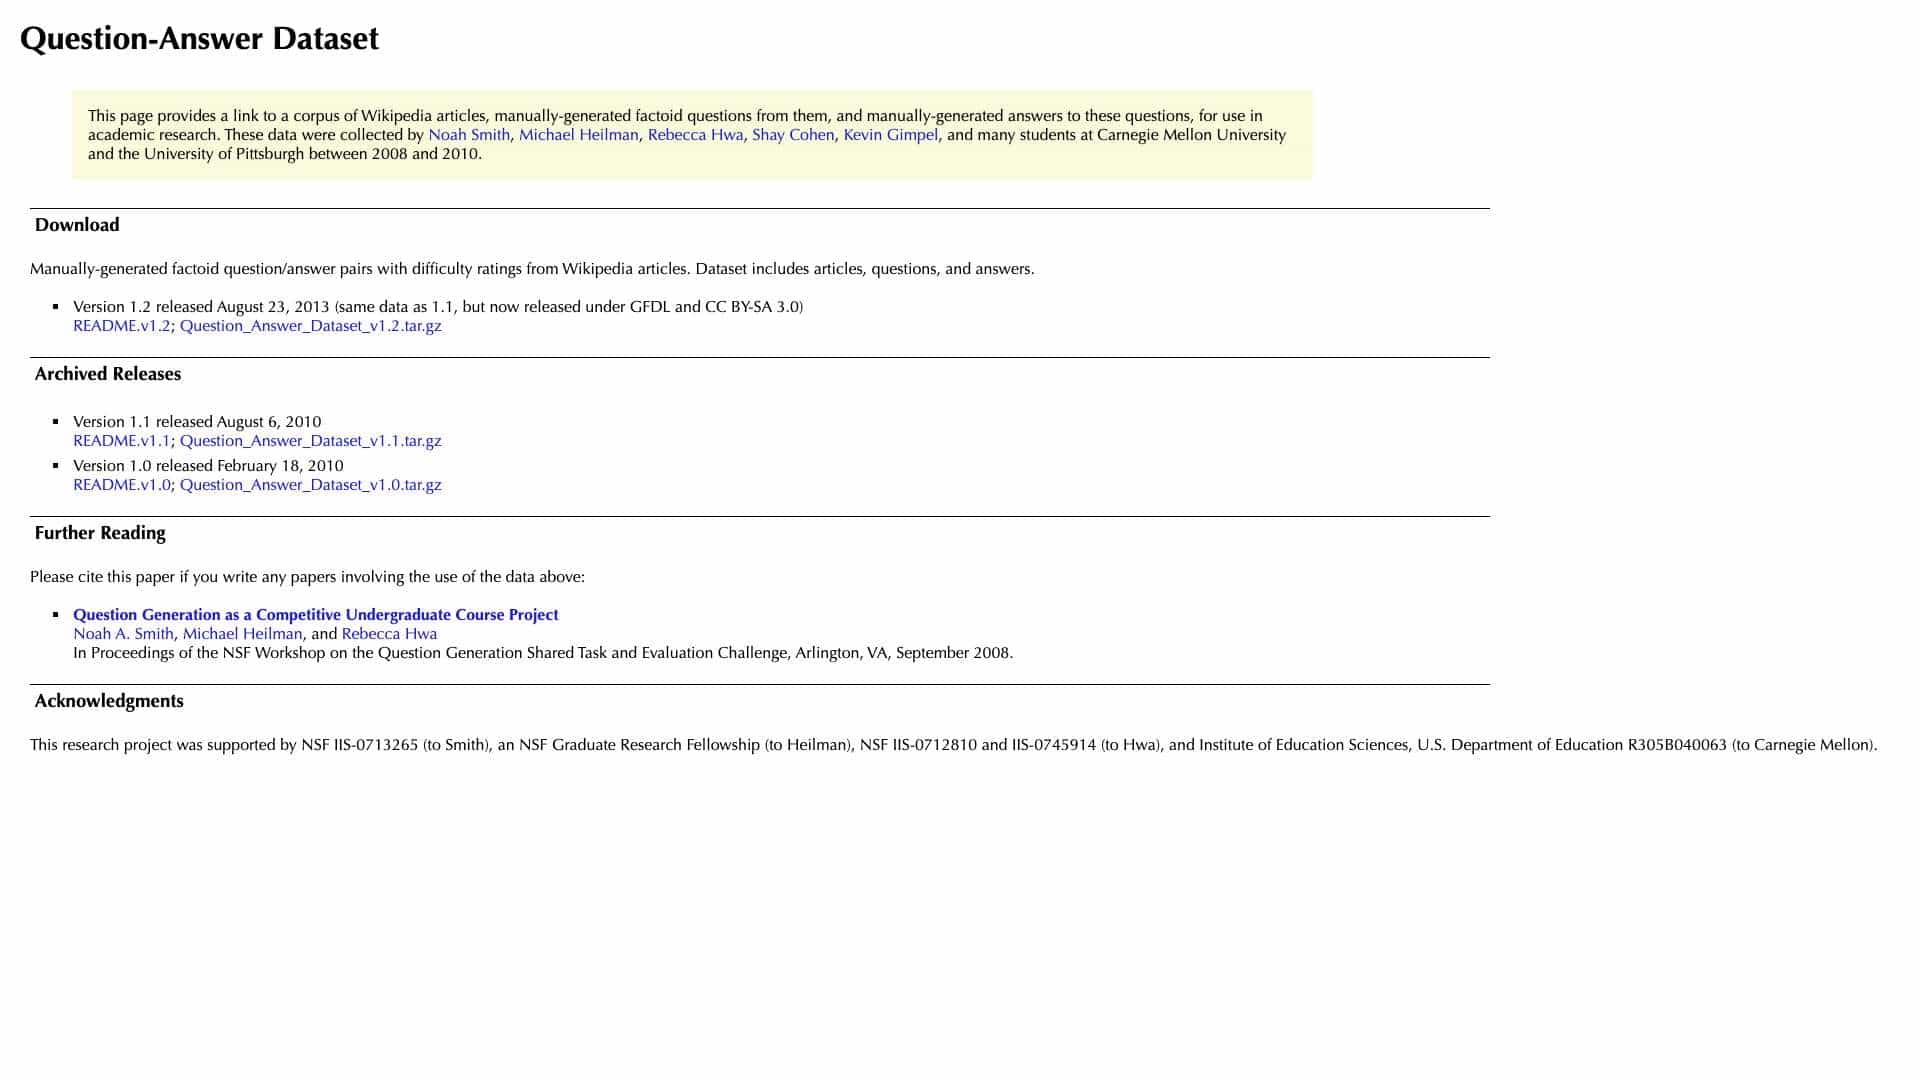
Este es un corpus de artículos de Wikipedia combinados con preguntas y respuestas factoides creadas manualmente, diseñado para su uso en investigaciones académicas sobre generación y respuesta de preguntas. Incluye clasificaciones de dificultad y múltiples versiones publicadas bajo licencias abiertas.
¿Para qué se usa CMU Q/A Dataset?
Características Principales
- Artículos de Wikipedia
- Preguntas generadas manualmente
- Respuestas generadas manualmente
- Clasificaciones de dificultad
- Varias versiones disponibles
- Licencias abiertas (GFDL, CC BY-SA)
¿Cómo usar CMU Q/A Dataset?
Descargue los archivos del conjunto de datos (por ejemplo, archivos tar.gz) de los enlaces proporcionados, extráigalos y utilice los artículos, preguntas y respuestas para proyectos de investigación, como capacitación o evaluación de modelos de procesamiento del lenguaje natural.
Herramientas Alternativas
No se encontraron herramientas alternativas
Pros & Contras
Pros
- Anotaciones manuales de alta calidad
- Útil para la investigación de PNL
- Gratis para descargar y usar
- Incluye citas académicas.
Contras
- Los datos del período 2008-2010 pueden estar desactualizados
- Limitado a preguntas factoides
- No hay actualizaciones activas ni soporte
Casos de Uso
- Investigación académica sobre respuesta a preguntas.
- Entrenamiento de modelos de aprendizaje automático
- Proyectos educativos en cursos de PNL.
Precios de CMU Q/A Dataset
Plan Gratuito
No hay información detallada de precios disponible
Reseñas de Usuarios
3.0
de 5
3.0
Aún no hay reseñas
¡Sé el primero en reseñar esta herramienta!