



ApacheTajo
Apache Tajo es un sistema de almacenamiento de big data distribuido en Hadoop para consultas SQL de baja latencia, ETL y procesamiento de datos escalable.
Puntuación
30
Calificación de Usuario
3.0
Soporte Gratuito/Prueba
No Soportado
Precio Inicial
--
Última Actualización
ago 04, 2026
Resumen
¿Qué es ApacheTajo?
Apache Tajo es un robusto sistema de almacenamiento de datos distribuido y relacional de big data diseñado para Apache Hadoop. Admite estándares SQL, permite consultas ad hoc de baja latencia, agregación en línea y ETL en grandes conjuntos de datos almacenados en HDFS y otras fuentes, con optimización de consultas avanzada y tolerancia a fallas.
¿Para qué se usa ApacheTajo?
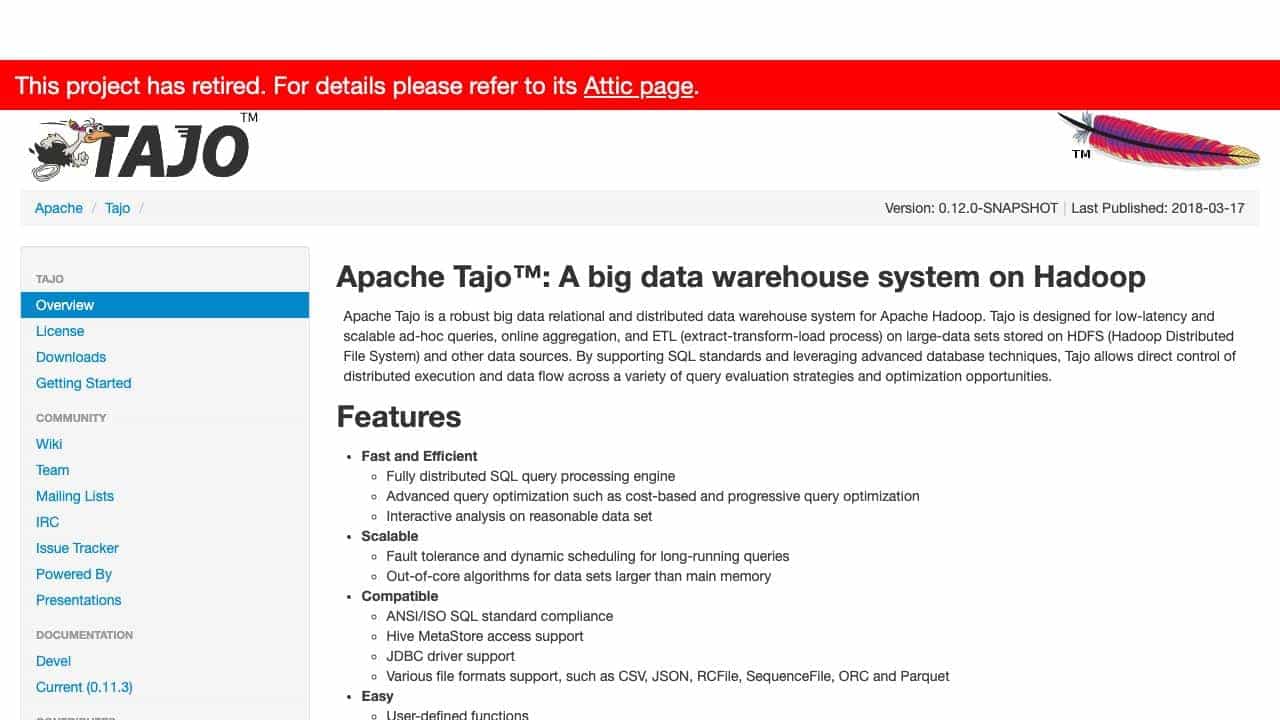
Características Principales
- Procesamiento distribuido de consultas SQL
- Optimización avanzada de consultas
- Tolerancia a fallos y programación dinámica
- Cumplimiento de ANSI/ISO SQL
- Soporte para varios formatos de archivos.
- Funciones definidas por el usuario
- Concha interactiva
- Soporte del controlador JDBC
¿Cómo usar ApacheTajo?
Implemente Tajo en clústeres de Hadoop, use SQL para consultar datos, aproveche JDBC para la conectividad y utilice su shell interactivo y API para el procesamiento y análisis de datos en grandes conjuntos de datos.
Herramientas Alternativas
No se encontraron herramientas alternativas
Pros & Contras
Pros
- Escalable para big data
- Consultas de baja latencia
- De código abierto y gratuito
- Compatible con el ecosistema Hadoop
- Admite múltiples fuentes de datos
Contras
- Proyecto retirado (sin desarrollo activo)
- Requiere infraestructura Hadoop
- Curva de aprendizaje pronunciada para principiantes
Casos de Uso
- Análisis e informes de big data
- Procesos ETL en Hadoop
- Exploración de datos interactiva
- Almacenamiento de datos para empresas
Reseñas de Usuarios
3.0
de 5
3.0
Aún no hay reseñas
¡Sé el primero en reseñar esta herramienta!