



CMU Q/A Dataset
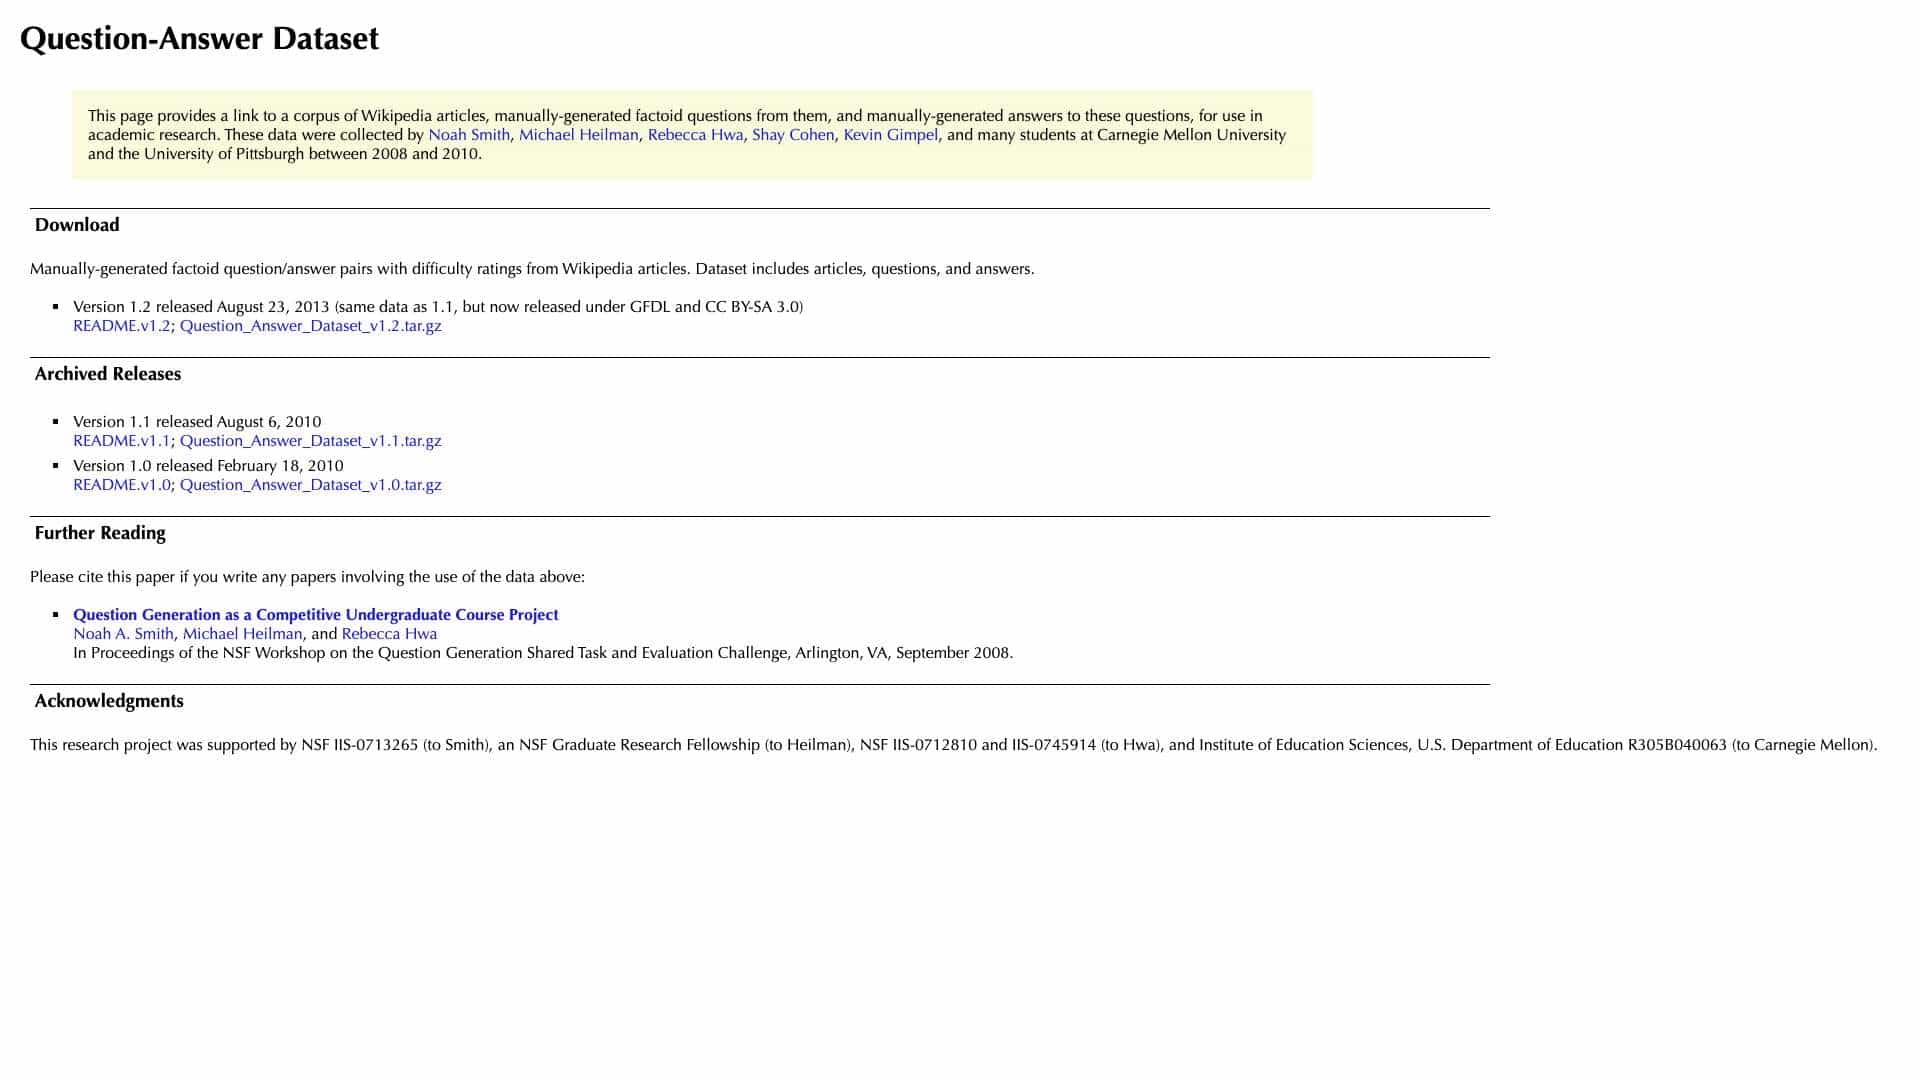
Ein Datensatz von Wikipedia-Artikeln mit manuell generierten Faktenfragen und Antworten für die akademische Forschung, gesammelt zwischen 2008 und 2010.
Punktzahl
30
Benutzerbewertung
3.0
Kostenlos/Test-Support
Unterstützt
Startpreis
--
Zuletzt Aktualisiert
Mai 02, 2026
Überblick
Was ist CMU Q/A Dataset?
Hierbei handelt es sich um einen Korpus von Wikipedia-Artikeln gepaart mit manuell erstellten Faktenfragen und -antworten, der für die Verwendung in der akademischen Forschung zur Fragengenerierung und -beantwortung konzipiert ist. Es enthält Schwierigkeitsgrade und mehrere Versionen, die unter offenen Lizenzen veröffentlicht wurden.
Wofür wird CMU Q/A Dataset verwendet?
Top-Funktionen
- Wikipedia-Artikel
- Manuell generierte Fragen
- Manuell generierte Antworten
- Schwierigkeitsbewertungen
- Mehrere Versionen verfügbar
- Offene Lizenzen (GFDL, CC BY-SA)
Wie verwendet man CMU Q/A Dataset?
Laden Sie die Datensatzdateien (z. B. tar.gz-Archive) über die bereitgestellten Links herunter, extrahieren Sie sie und verwenden Sie die Artikel, Fragen und Antworten für Forschungsprojekte, beispielsweise für Schulungen oder die Bewertung von Modellen zur Verarbeitung natürlicher Sprache.
Alternative Tools
Keine alternativen Tools gefunden
Vorteile & Nachteile
Vorteile
- Hochwertige manuelle Anmerkungen
- Nützlich für die NLP-Forschung
- Kostenloser Download und Nutzung
- Enthält akademische Zitate
Nachteile
- Die Daten aus den Jahren 2008–2010 sind möglicherweise veraltet
- Beschränkt auf sachliche Fragen
- Keine aktiven Updates oder Support
Anwendungsfälle
- Akademische Forschung zur Beantwortung von Fragen
- Trainieren von Modellen für maschinelles Lernen
- Bildungsprojekte in NLP-Kursen
CMU Q/A Dataset Preise
Kostenloser Plan
Keine detaillierten Preisinformationen verfügbar
Benutzerbewertungen
3.0
von 5
3.0
Noch keine Bewertungen
Seien Sie der Erste, der dieses Tool bewertet!