



ApacheTajo
Apache Tajo ist ein verteiltes Big-Data-Warehouse-System auf Hadoop für SQL-Abfragen mit geringer Latenz, ETL und skalierbare Datenverarbeitung.
Punktzahl
30
Benutzerbewertung
3.0
Kostenlos/Test-Support
Nicht Unterstützt
Startpreis
--
Zuletzt Aktualisiert
Aug. 04, 2026
Überblick
Was ist ApacheTajo?
Apache Tajo ist ein robustes relationales und verteiltes Big-Data-Data-Warehouse-System, das für Apache Hadoop entwickelt wurde. Es unterstützt SQL-Standards, ermöglicht Ad-hoc-Abfragen mit geringer Latenz, Online-Aggregation und ETL für große Datensätze, die auf HDFS und anderen Quellen gespeichert sind, mit erweiterter Abfrageoptimierung und Fehlertoleranz.
Wofür wird ApacheTajo verwendet?
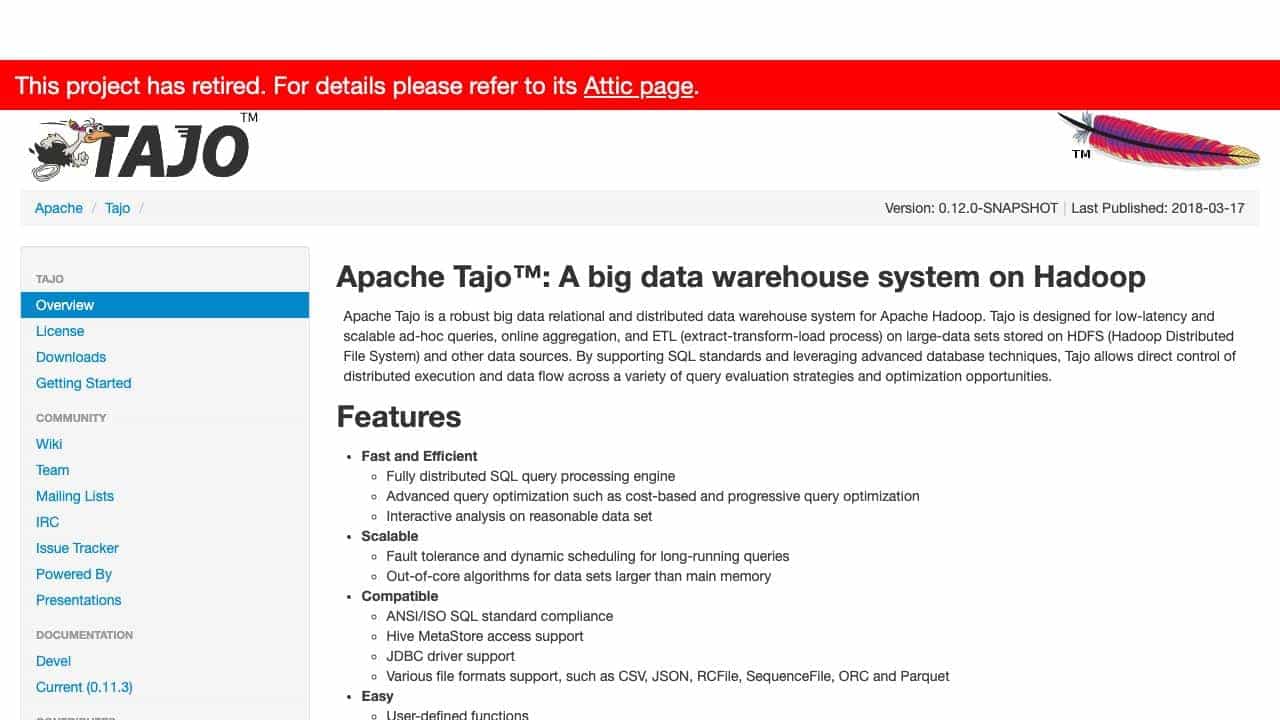
Top-Funktionen
- Verteilte SQL-Abfrageverarbeitung
- Erweiterte Abfrageoptimierung
- Fehlertoleranz und dynamische Planung
- ANSI/ISO SQL-Konformität
- Unterstützung für verschiedene Dateiformate
- Benutzerdefinierte Funktionen
- Interaktive Shell
- JDBC-Treiberunterstützung
Wie verwendet man ApacheTajo?
Stellen Sie Tajo auf Hadoop-Clustern bereit, verwenden Sie SQL zum Abfragen von Daten, nutzen Sie JDBC für die Konnektivität und nutzen Sie die interaktive Shell und APIs für die Datenverarbeitung und Analyse großer Datenmengen.
Alternative Tools
Keine alternativen Tools gefunden
Vorteile & Nachteile
Vorteile
- Skalierbar für Big Data
- Abfragen mit geringer Latenz
- Open Source und kostenlos
- Kompatibel mit dem Hadoop-Ökosystem
- Unterstützt mehrere Datenquellen
Nachteile
- Zurückgezogenes Projekt (keine aktive Entwicklung)
- Erfordert Hadoop-Infrastruktur
- Steile Lernkurve für Anfänger
Anwendungsfälle
- Big-Data-Analyse und Reporting
- ETL-Prozesse auf Hadoop
- Interaktive Datenexploration
- Data Warehousing für Unternehmen
Benutzerbewertungen
3.0
von 5
3.0
Noch keine Bewertungen
Seien Sie der Erste, der dieses Tool bewertet!