



CMU Q/A Dataset
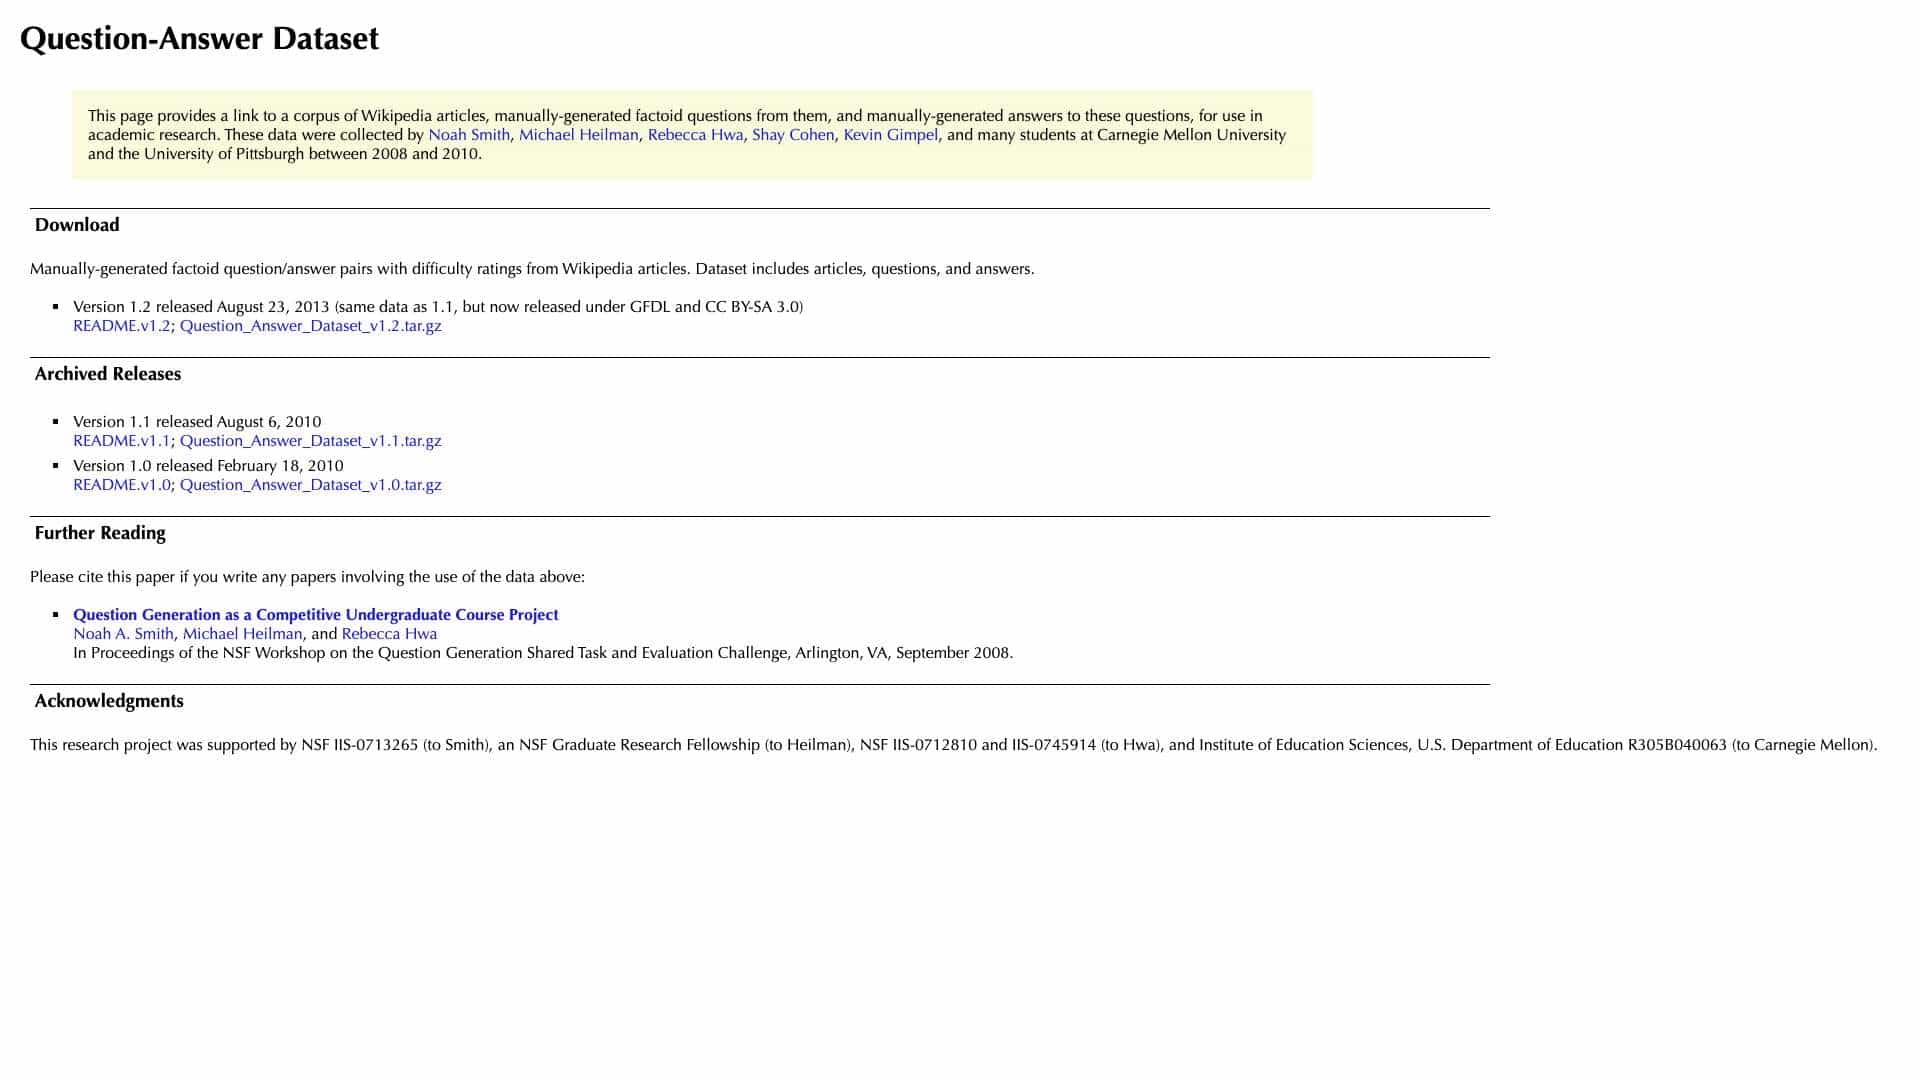
A dataset of Wikipedia articles with manually-generated factoid questions and answers for academic research, collected between 2008-2010.
স্কোর
30
ব্যবহারকারীর রেটিং
3.0
বিনামূল্যে/ট্রায়াল সহায়তা
সমর্থিত
শুরুর মূল্য
--
সর্বশেষ আপডেট
জুন 10, 2026
সংক্ষিপ্তসার
CMU Q/A Dataset কী?
এটি ম্যানুয়ালি তৈরি করা ফ্যাক্টয়েড প্রশ্ন এবং উত্তরগুলির সাথে যুক্ত উইকিপিডিয়া নিবন্ধগুলির একটি সংগ্রহ, প্রশ্ন তৈরি এবং উত্তর দেওয়ার বিষয়ে একাডেমিক গবেষণায় ব্যবহারের জন্য ডিজাইন করা হয়েছে। এতে অসুবিধা রেটিং এবং খোলা লাইসেন্সের অধীনে প্রকাশিত একাধিক সংস্করণ অন্তর্ভুক্ত রয়েছে।
CMU Q/A Dataset কী কাজে ব্যবহৃত হয়?
শীর্ষ বৈশিষ্ট্য
- উইকিপিডিয়া নিবন্ধ
- ম্যানুয়ালি তৈরি করা প্রশ্ন
- ম্যানুয়ালি তৈরি করা উত্তর
- অসুবিধা রেটিং
- একাধিক সংস্করণ উপলব্ধ
- খোলা লাইসেন্স (GFDL, CC BY-SA)
CMU Q/A Dataset কীভাবে ব্যবহার করবেন?
প্রদত্ত লিঙ্কগুলি থেকে ডেটাসেট ফাইলগুলি (যেমন, tar.gz সংরক্ষণাগারগুলি) ডাউনলোড করুন, সেগুলি বের করুন এবং গবেষণা প্রকল্পগুলির জন্য নিবন্ধ, প্রশ্ন এবং উত্তরগুলি ব্যবহার করুন, যেমন প্রশিক্ষণ বা প্রাকৃতিক ভাষা প্রক্রিয়াকরণ মডেলের মূল্যায়ন।
বিকল্প টুল
কোন বিকল্প টুল পাওয়া যায়নি
সুবিধা & অসুবিধা
সুবিধা
- উচ্চ-মানের ম্যানুয়াল টীকা
- NLP গবেষণার জন্য দরকারী
- ডাউনলোড এবং ব্যবহার বিনামূল্যে
- একাডেমিক উদ্ধৃতি অন্তর্ভুক্ত
অসুবিধা
- 2008-2010 এর ডেটা পুরানো হতে পারে
- বাস্তব প্রশ্নে সীমাবদ্ধ
- কোন সক্রিয় আপডেট বা সমর্থন
ব্যবহারের ক্ষেত্রে
- প্রশ্নের উত্তরে একাডেমিক গবেষণা
- মেশিন লার্নিং মডেল প্রশিক্ষণ
- এনএলপি কোর্সে শিক্ষামূলক প্রকল্প
CMU Q/A Dataset মূল্য
বিনামূল্যে পরিকল্পনা
কোন বিশদ মূল্য তথ্য উপলব্ধ নেই
ব্যবহারকারীর পর্যালোচনা
3.0
৫ এর মধ্যে
3.0
এখনও কোন পর্যালোচনা নেই
এই টুলের প্রথম পর্যালোচনাকারী হন!