



ApacheTajo
Apache Tajo,SQL-on-Hadoop,big data warehouse system on Hadoop,relational and distributed query engine
স্কোর
30
ব্যবহারকারীর রেটিং
3.0
বিনামূল্যে/ট্রায়াল সহায়তা
সমর্থিত নয়
শুরুর মূল্য
--
সর্বশেষ আপডেট
আগস্ট 04, 2026
সংক্ষিপ্তসার
ApacheTajo কী?
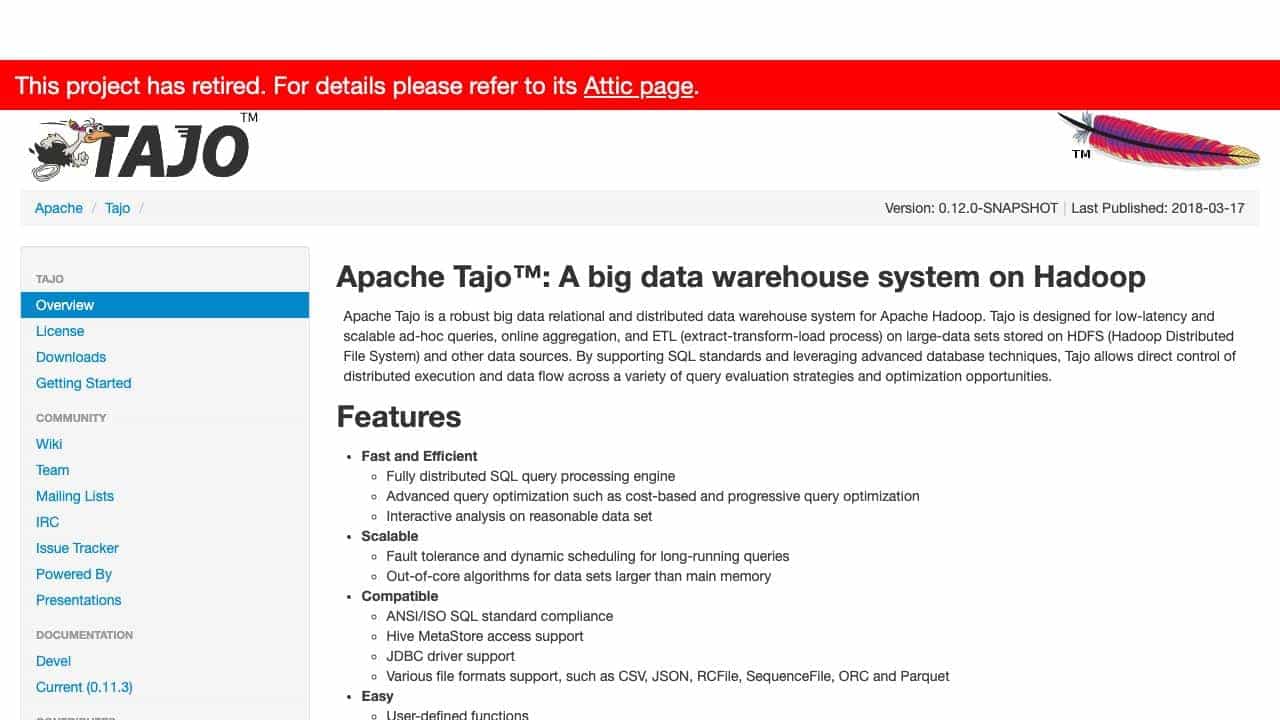
Apache Tajo হল Apache Hadoop-এর জন্য ডিজাইন করা একটি শক্তিশালী বড় ডেটা রিলেশনাল এবং ডিস্ট্রিবিউটেড ডাটা গুদাম ব্যবস্থা। এটি এসকিউএল স্ট্যান্ডার্ড সমর্থন করে, উন্নত ক্যোয়ারী অপ্টিমাইজেশান এবং ত্রুটি সহনশীলতা সহ HDFS এবং অন্যান্য উত্সগুলিতে সঞ্চিত বৃহৎ ডেটাসেটে লো-লেটেন্সি অ্যাড-হক প্রশ্ন, অনলাইন একত্রীকরণ এবং ETL সক্ষম করে৷
ApacheTajo কী কাজে ব্যবহৃত হয়?
শীর্ষ বৈশিষ্ট্য
- বিতরণ করা SQL কোয়েরি প্রক্রিয়াকরণ
- উন্নত ক্যোয়ারী অপ্টিমাইজেশান
- ফল্ট সহনশীলতা এবং গতিশীল সময়সূচী
- ANSI/ISO SQL সম্মতি
- বিভিন্ন ফাইল ফরম্যাটের জন্য সমর্থন
- ব্যবহারকারী-সংজ্ঞায়িত ফাংশন
- ইন্টারেক্টিভ শেল
- JDBC ড্রাইভার সমর্থন
ApacheTajo কীভাবে ব্যবহার করবেন?
Hadoop ক্লাস্টারগুলিতে তাজো স্থাপন করুন, ডেটা অনুসন্ধানের জন্য SQL ব্যবহার করুন, সংযোগের জন্য JDBC-এর সুবিধা নিন এবং বড় ডেটা সেটগুলিতে ডেটা প্রক্রিয়াকরণ এবং বিশ্লেষণের জন্য এর ইন্টারেক্টিভ শেল এবং APIগুলি ব্যবহার করুন৷
বিকল্প টুল
কোন বিকল্প টুল পাওয়া যায়নি
সুবিধা & অসুবিধা
সুবিধা
- বড় ডেটার জন্য মাপযোগ্য
- কম লেটেন্সি প্রশ্ন
- ওপেন সোর্স এবং বিনামূল্যে
- Hadoop ইকোসিস্টেমের সাথে সামঞ্জস্যপূর্ণ
- একাধিক ডেটা উত্স সমর্থন করে
অসুবিধা
- অবসরপ্রাপ্ত প্রকল্প (কোন সক্রিয় উন্নয়ন নেই)
- Hadoop পরিকাঠামো প্রয়োজন
- নতুনদের জন্য খাড়া শেখার বক্ররেখা
ব্যবহারের ক্ষেত্রে
- বড় তথ্য বিশ্লেষণ এবং রিপোর্টিং
- Hadoop এ ETL প্রসেস করে
- ইন্টারেক্টিভ ডেটা এক্সপ্লোরেশন
- উদ্যোগের জন্য ডেটা গুদামজাতকরণ
ব্যবহারকারীর পর্যালোচনা
3.0
৫ এর মধ্যে
3.0
এখনও কোন পর্যালোচনা নেই
এই টুলের প্রথম পর্যালোচনাকারী হন!