



SQuAD
Stanford Question Answering Dataset (SQuAD) is a new reading comprehension dataset, consisting of questions posed by crowdworkers on a set of Wikipedia articles, where the answer to every question is a segment of text, or span, from the corresponding reading passage. With 100,000+ question-answer pairs on 500+ articles, SQuAD is significantly larger than previous reading comprehension datasets.
النتيجة
30
تقييم المستخدم
3.0
دعم مجاني/تجريبي
مدعوم
السعر الأولي
--
آخر تحديث
مايو 02, 2026
نظرة عامة
ما هو SQuAD؟
مجموعة بيانات الإجابة على الأسئلة في جامعة ستانفورد (SQuAD) هي مجموعة بيانات لفهم القراءة تتكون من أسئلة حول مقالات ويكيبيديا، حيث تكون الإجابات عبارة عن امتدادات نصية من المقاطع. يضيف SQuAD2.0 أسئلة غير قابلة للإجابة لاختبار قدرة الأنظمة على الامتناع عن التصويت في حالة عدم وجود إجابة.
فيم يستخدم SQuAD؟
أفضل الميزات
- مجموعة بيانات القراءة والفهم
- يتضمن أسئلة قابلة للإجابة وغير قابلة للإجابة
- سكريبت التقييم متاح
- المتصدرين لمقارنة النموذج
- التنزيل مجاني بموجب ترخيص CC BY-SA 4.0
كيفية استخدام SQuAD؟
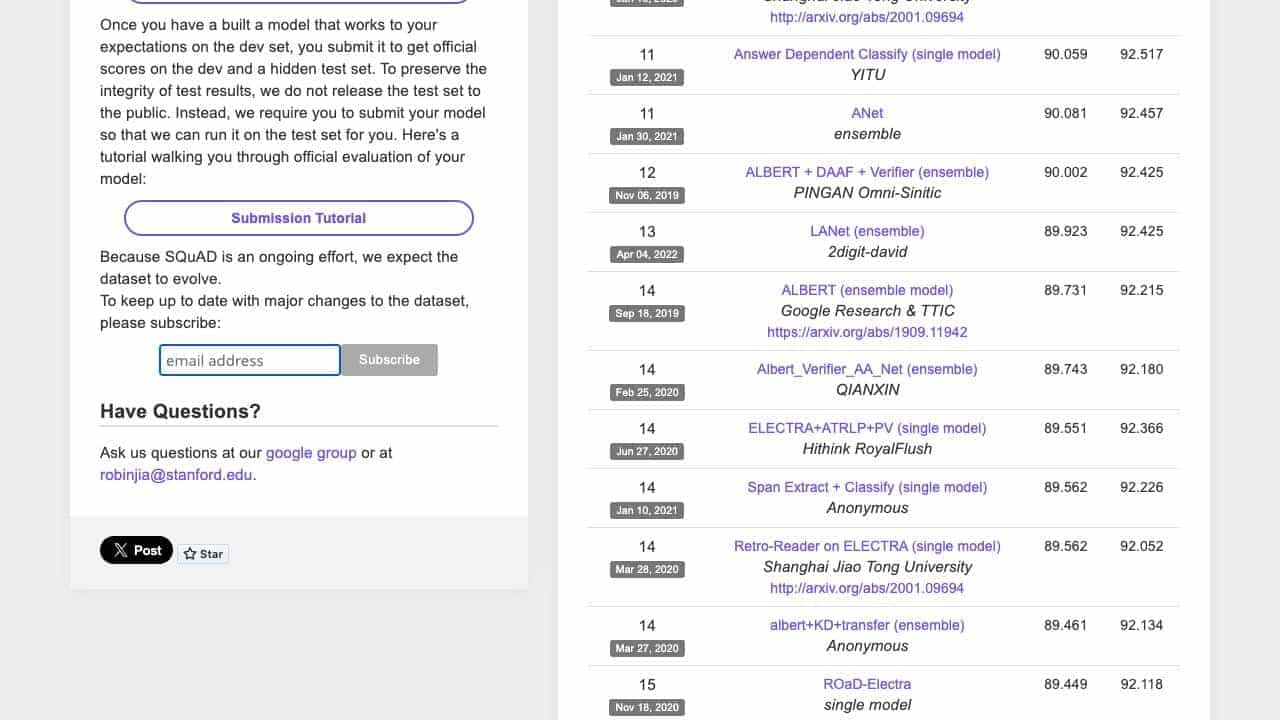
قم بتنزيل مجموعة البيانات، واستخدم البرنامج النصي للتقييم لاختبار النماذج على مجموعات التطوير، وإرسال نماذج للتسجيل الرسمي على مجموعات الاختبار المخفية عبر البرنامج التعليمي المقدم.
أدوات بديلة
لم يتم العثور على أدوات بديلة
الإيجابيات & السلبيات
الإيجابيات
- معيار عالي الجودة للبرمجة اللغوية العصبية
- مجانية ومفتوحة المصدر
- يدعم تقييم النموذج وتقديمه
- تستخدم على نطاق واسع في البحث الأكاديمي
السلبيات
- يقتصر على النص الإنجليزي
- يتطلب الخبرة الفنية للاستخدام
- لا توجد أدوات مدمجة للتدريب النموذجي
حالات الاستخدام
- تدريب نماذج الذكاء الاصطناعي للإجابة على الأسئلة
- البحث الأكاديمي في البرمجة اللغوية العصبية
- مقارنة أنظمة التعلم الآلي
أسعار SQuAD
الخطة المجانية
لا توجد معلومات مفصلة عن الأسعار
تقييمات المستخدمين
3.0
من 5
3.0
لا توجد تقييمات بعد
كن أول من يقيم هذه الأداة!