



CMU Q/A Dataset
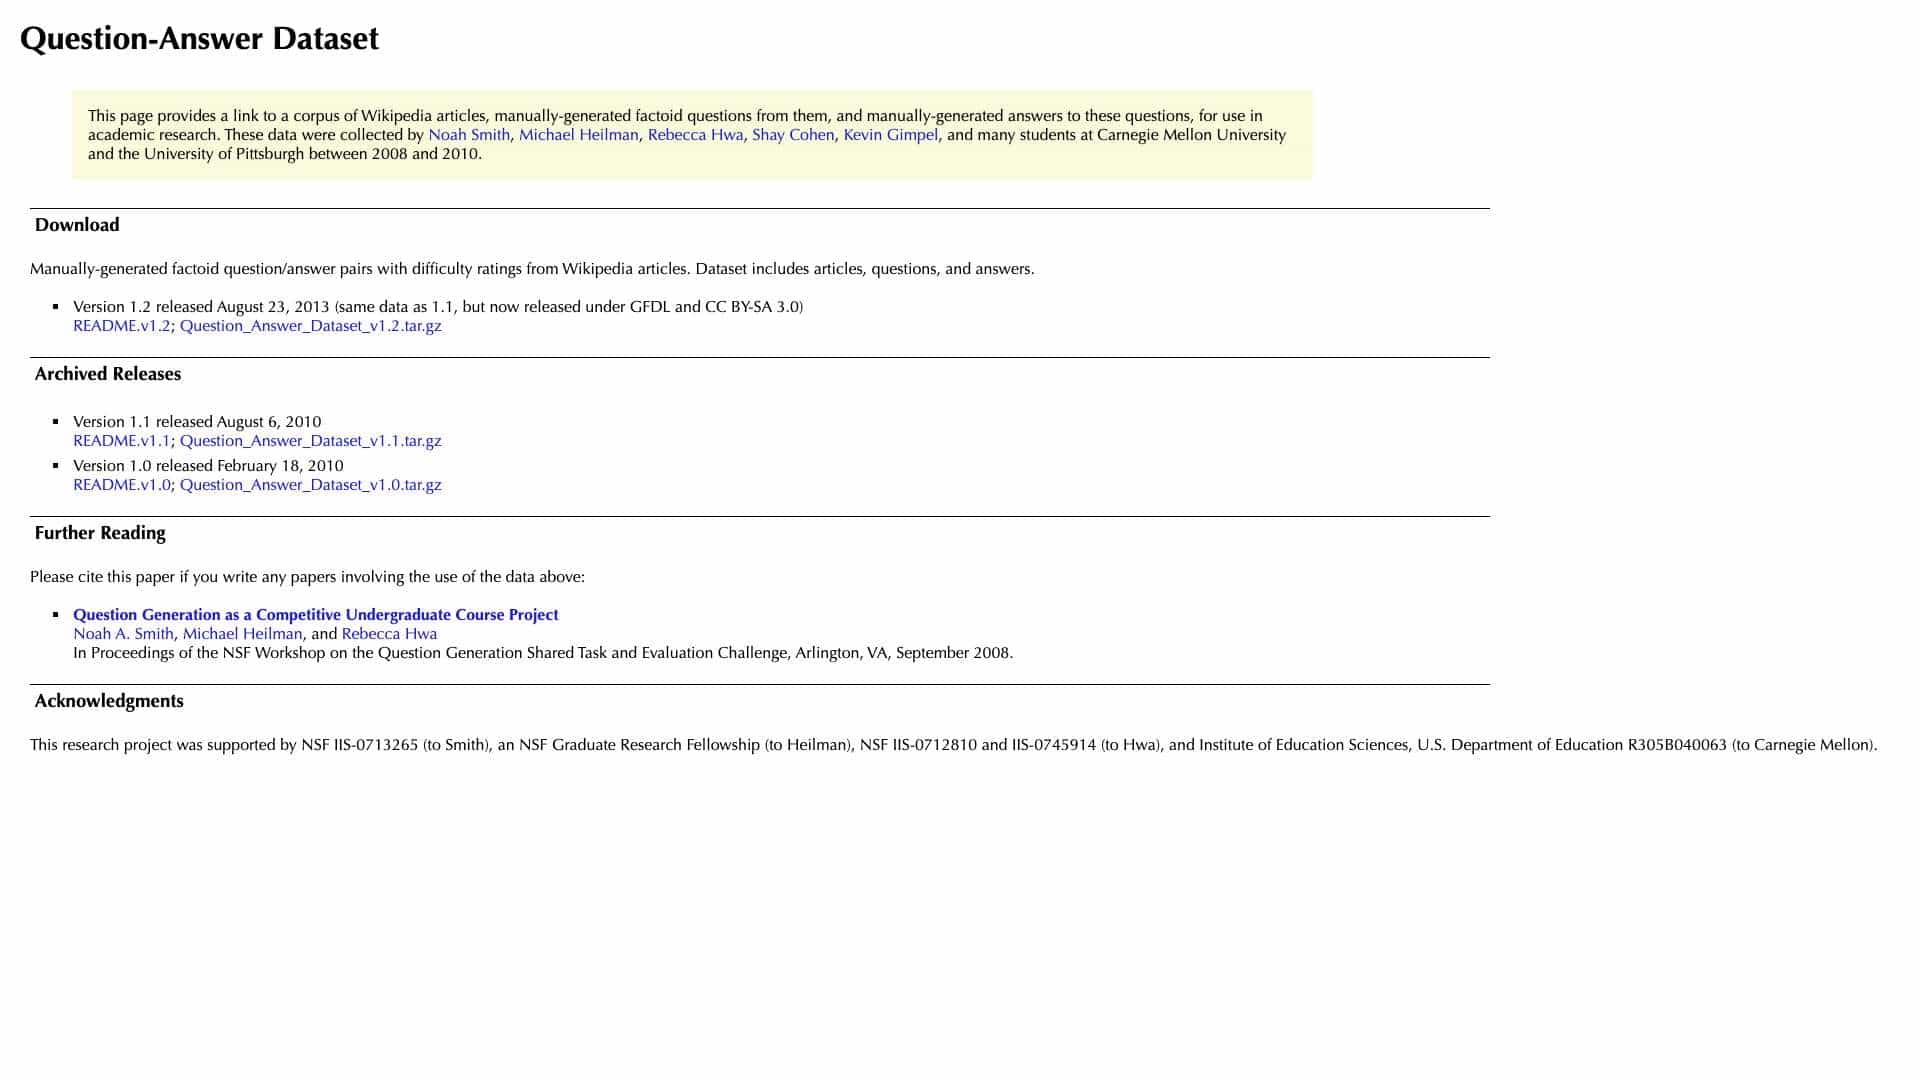
A dataset of Wikipedia articles with manually-generated factoid questions and answers for academic research, collected between 2008-2010.
النتيجة
30
تقييم المستخدم
3.0
دعم مجاني/تجريبي
مدعوم
السعر الأولي
--
آخر تحديث
يونيو 10, 2026
نظرة عامة
ما هو CMU Q/A Dataset؟
هذه مجموعة من مقالات ويكيبيديا مقترنة بأسئلة وإجابات واقعية تم إنشاؤها يدويًا، ومصممة للاستخدام في البحث الأكاديمي حول توليد الأسئلة والإجابة عليها. يتضمن تقييمات الصعوبة وإصدارات متعددة تم إصدارها بموجب تراخيص مفتوحة.
فيم يستخدم CMU Q/A Dataset؟
أفضل الميزات
- مقالات ويكيبيديا
- الأسئلة التي تم إنشاؤها يدويا
- الإجابات التي تم إنشاؤها يدويا
- تقييمات الصعوبة
- إصدارات متعددة متاحة
- التراخيص المفتوحة (GFDL, CC BY-SA)
كيفية استخدام CMU Q/A Dataset؟
قم بتنزيل ملفات مجموعة البيانات (على سبيل المثال، أرشيفات tar.gz) من الروابط المتوفرة، واستخرجها، واستخدم المقالات والأسئلة والأجوبة لمشاريع البحث، مثل التدريب أو تقييم نماذج معالجة اللغة الطبيعية.
أدوات بديلة
لم يتم العثور على أدوات بديلة
الإيجابيات & السلبيات
الإيجابيات
- شروح يدوية عالية الجودة
- مفيد لأبحاث البرمجة اللغوية العصبية
- مجاني للتنزيل والاستخدام
- يتضمن الاستشهادات الأكاديمية
السلبيات
- قد تكون البيانات من الفترة 2008-2010 قديمة
- تقتصر على الأسئلة الواقعية
- لا توجد تحديثات أو دعم نشط
حالات الاستخدام
- بحث أكاديمي حول الإجابة على الأسئلة
- نماذج التعلم الآلي للتدريب
- المشاريع التعليمية في دورات البرمجة اللغوية العصبية
أسعار CMU Q/A Dataset
الخطة المجانية
لا توجد معلومات مفصلة عن الأسعار
تقييمات المستخدمين
3.0
من 5
3.0
لا توجد تقييمات بعد
كن أول من يقيم هذه الأداة!