



Billion Words
A benchmark dataset for language modeling experiments with 1 billion words, providing training/test data and baseline model outputs for reproducible research.
النتيجة
30
تقييم المستخدم
3.0
دعم مجاني/تجريبي
غير مدعوم
السعر الأولي
--
آخر تحديث
أغسطس 04, 2026
نظرة عامة
ما هو Billion Words؟
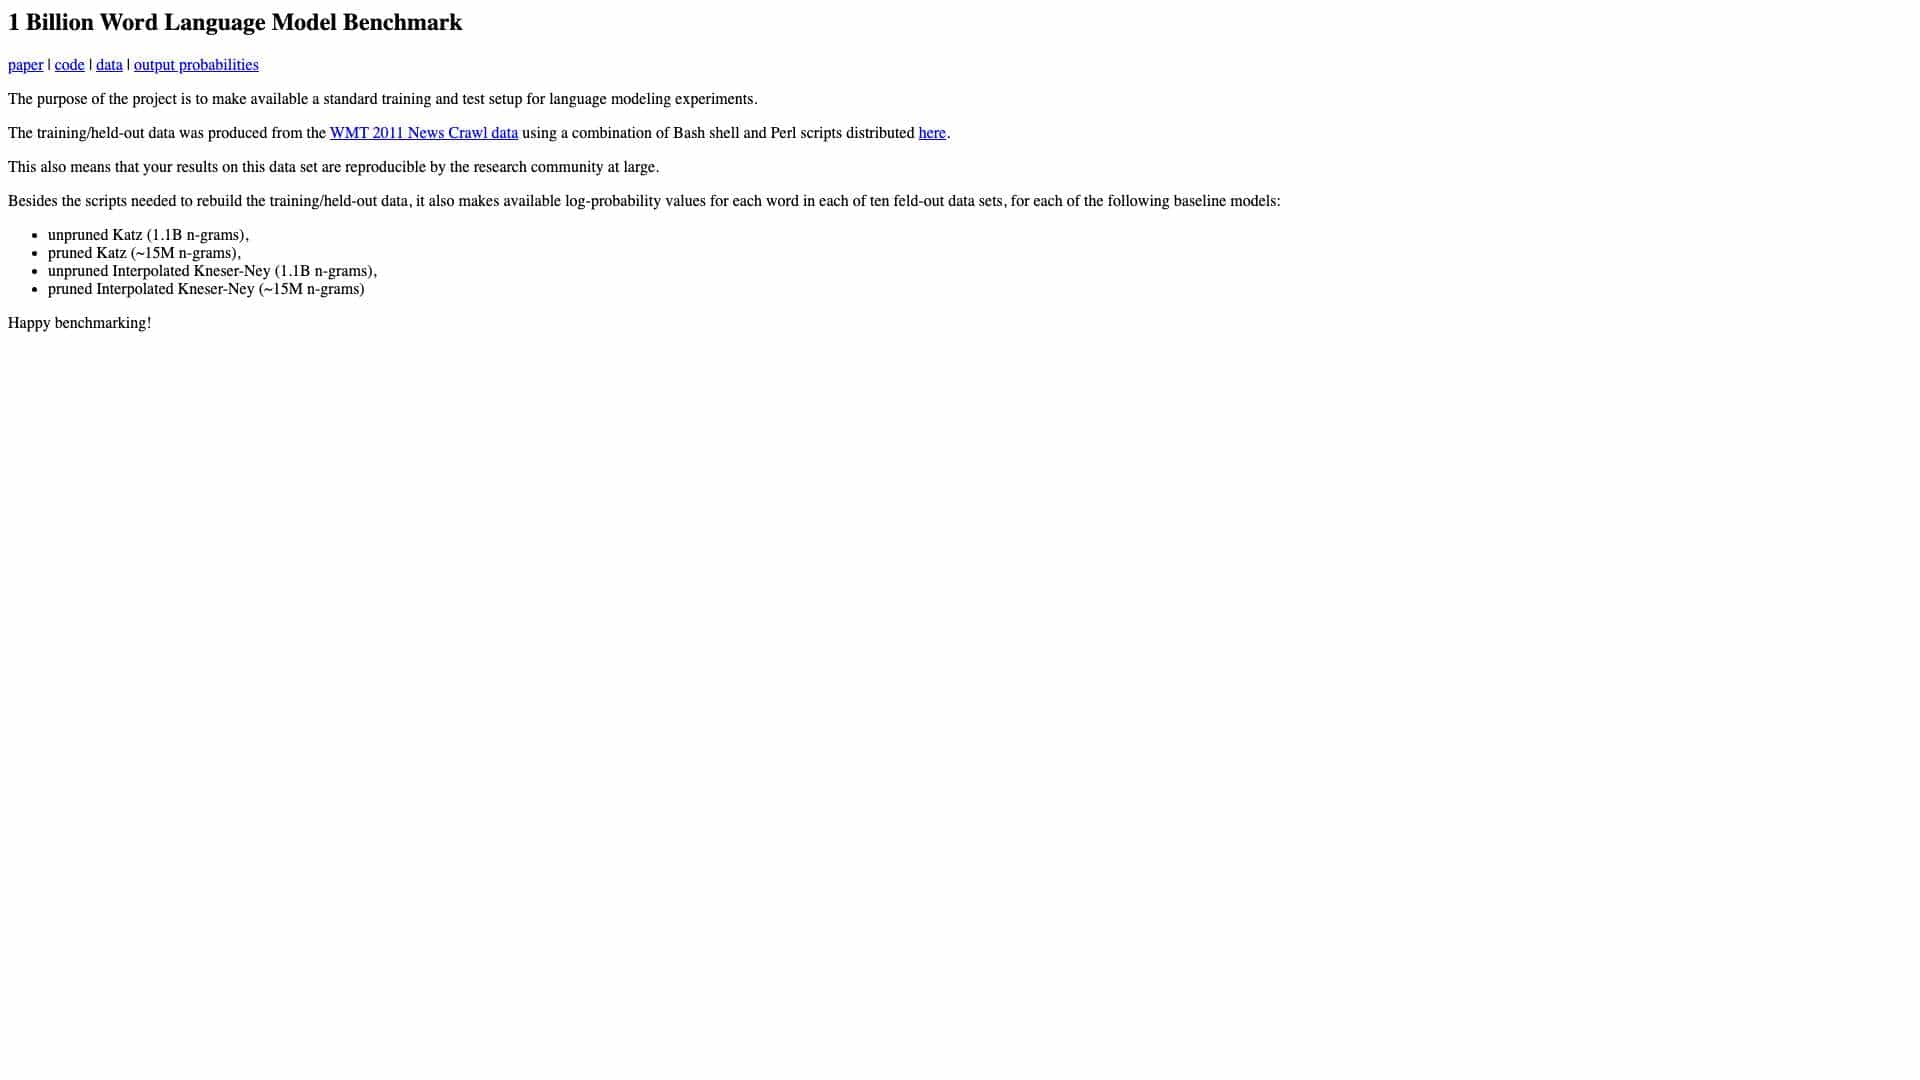
يقدم مشروع Billion Word تدريبًا قياسيًا وإعدادًا للاختبار لنمذجة اللغة، باستخدام بيانات WMT 2011 News Crawl. وهو يتضمن نصوصًا برمجية لإعادة بناء البيانات وقيم احتمالية السجل لنماذج خط الأساس مثل Katz وKneser-Ney، مما يتيح إمكانية قياس الأداء القابل للتكرار في أبحاث البرمجة اللغوية العصبية.
فيم يستخدم Billion Words؟
أفضل الميزات
- مجموعة بيانات 1 مليار كلمة
- بيانات التدريب والاختبار
- مخرجات النموذج الأساسي
- البرامج النصية القابلة للتكرار
كيفية استخدام Billion Words؟
قم بتنزيل البرامج النصية والبيانات المقدمة لإعداد تجارب نمذجة اللغة. استخدم بيانات التدريب لتطوير النموذج والبيانات المحفوظة للاختبار، ومقارنة النتائج مع النماذج الأساسية باستخدام مخرجات احتمالية السجل المتاحة.
أدوات بديلة
لم يتم العثور على أدوات بديلة
الإيجابيات & السلبيات
الإيجابيات
- معيار موحد
- نتائج قابلة للتكرار
- مجانية ومفتوحة المصدر
- يدعم نماذج متعددة
السلبيات
- يتطلب الإعداد الفني
- يقتصر على مصدر بيانات محدد
حالات الاستخدام
- مقارنة أبحاث البرمجة اللغوية العصبية
- تطوير نموذج اللغة
- التجارب الأكاديمية
تقييمات المستخدمين
3.0
من 5
3.0
لا توجد تقييمات بعد
كن أول من يقيم هذه الأداة!